
Картина знакома многим, кто загружает ролики повторно. Видео опубликовано второй раз. Охватов нет. Метаданные почищены, файл пересохранён, вес другой. Результата всё равно нет.
На форуме этот вопрос звучит так: «слетит ли монета с канала, если начать перезаливать свои видео с другого своего же канала?» 1. Спрашивает человек, который собирался повторно загружать свои ролики на свой второй канал. Он хотел знать заранее, чем это кончится.
Стороннего сервиса, который сверит ваш файл с отпечатком площадки и скажет «пройдёт» или «не пройдёт», нет. Мы искали. Как именно — сказано ниже. Сверить ролик с базой до публикации может только сама площадка. В YouTube Studio черновик проверяется на совпадения по авторским правам.
Байты файла и отпечаток картинки вы проверите у себя. Для этого хватит короткого скрипта на Python. Он считает расстояние между отпечатками для целой папки копий. Рецепт — в разделе «С чего начать». Сравнить два видео умеет и наша бесплатная программа Unique Rate для Windows. Но в этом замере мы её не использовали. Другие способы проверить ролик — в разделе «Проверка видео на уникальность до публикации».
Главный итог замера такой. Чистка метаданных, пересжатие, слабый шум и лёгкая правка света делают файл новым по байтам. Отпечаток картинки они сдвигают в среднем меньше чем на бит из 64. Подпись поверх кадра сдвигает его на 3 бита. Обрезка и рамка сдвигают его на 6-10 битов. Зеркало сдвигает его на 31 бит. Сдвиг тона и ускорение сильнее всего уменьшают число меток нашего звукового отпечатка. Мерили на четырёх роликах настоящей съёмки.
Про «мы» скажем сразу. Мы делаем Video Unique Booster — программу для массовой обработки видео. То есть мы продавец. Поэтому обещаний за площадку ниже нет. Есть свой замер, чужие опубликованные работы и прямо названные границы того и другого.
Кому это нужно
Тем, кто публикует ролики десятками — в TikTok, Reels или Shorts. Тем, кто повторно загружает своё или чужое. Тем, кто платил за уникализацию и не понял, за что именно.
Не нужно тем, кто снимает сам и публикует ролик раз в неделю. Проверка такому человеку ничего не добавит.
Отдельно — тем, кто выбирает сервис уникализации. Станет видно, какие обещания продавца вообще проверяемы.
Уникализатор видео для Windows: сотни копий за запускВручную Вы правите копию за копией. Программа создаёт их пачкой. У каждой свои картинка, звук, метаданные и длительность.
Уникализатор видео Video Unique Booster для WindowsВы кладёте видео и задаёте диапазоны настроек. Программа создаёт сотни копий. У каждой свои картинка, звук и длительность.
Уникализатор видео: сотни копий из одного оригиналаРучной способ упирается в одно. Каждую копию надо править отдельно. Больше копий — больше времени.
Уникализатор видео для TikTok, YouTube и InstagramДиапазоны настроек Вы задаёте один раз. Дальше программа для Windows создаёт копии пачкой. Сотнями за запуск.
Уникализатор видео для Windows — Video Unique BoosterВы добавляете одно видео. Программа создаёт сотни копий. У каждой свои картинка, звук, метаданные и длительность.
Что понадобится
Свой ролик. Командная строка Windows. Бесплатная программа ffmpeg 2. Для отпечатка картинки — Python с библиотекой imagehash.
Из архива ffmpeg нужен файл ffmpeg.exe из папки bin. Проще всего положить его в папку с роликом и запускать команды из неё. Командная строка ищет программу и в текущей папке. Python ставят установщиком для Windows. При установке отмечают пункт о добавлении в PATH, иначе команда python не найдётся.
Байты файла и отпечаток картинки проверяются на вашем же файле. Команды для этого напечатаны ниже.
Со звуком сложнее. Звуковой отпечаток мы считали своим кодом. Это около шестидесяти строк на Python. Шаги такие: сведение дорожки в моно, построение спектрограммы, поиск громких точек, запись расстояний между ними. Открытые системы такого рода есть, например Audfprint Дэна Эллиса 3, с которым сравнивают Panako в работе 4. Но это отдельный проект со своей установкой. В рецепт статьи он не помещается. То же и с программами криминалистов, которые определяют, каким аппаратом снят ролик.
След 1: байты файла
Хеш файла считают по байтам. Изменился один байт — хеш меняется целиком. Это тот самый «цифровой отпечаток». О нём пишут подборки по уникализации.
По этому следу находят только точные копии. Скачали ролик, загрузили на площадку без единой правки — совпадение точное.
Из этого делают неверный вывод: раз хеш меняется от любой правки, значит правкой можно превратить ролик в другой. Так не выходит. По справке YouTube, Content ID сверяет аудио и видео с базой правообладателей 5. О байтах файла там речи нет.
Метаданные относятся к тому же следу. Это служебные записи внутри файла: дата съёмки, модель аппарата, имя программы. Их чистят первым делом. Что в них бывает и как их убрать, подробно разобрано в статье «Как удалить метаданные с видео».
След оставляют не только они, но и само устройство контейнера MP4. Это порядок и состав служебных блоков. По ним авторы работы 6 определяют марку и модель аппарата на наборе из 578 роликов. Заодно они видят, пересобирали ли файл.
Проверьте на своём файле. Команда ffmpeg -i video.mp4 -map_metadata -1 -c copy clean.mp4 убирает метаданные. Картинку она не трогает. Файл станет другим по байтам.
След 2: как узнают картинку
Перцептивный хеш считают не по байтам, а по изображению.
Устроен он так. Кадр уменьшают до крошечного размера, убирают цвет, раскладывают на частоты и оставляют низкие: они описывают крупные пятна кадра. Каждую из них сравнивают с медианой. Частота выше медианы даёт единицу, ниже медианы — ноль. Получается короткий код. У похожих картинок коды похожи.
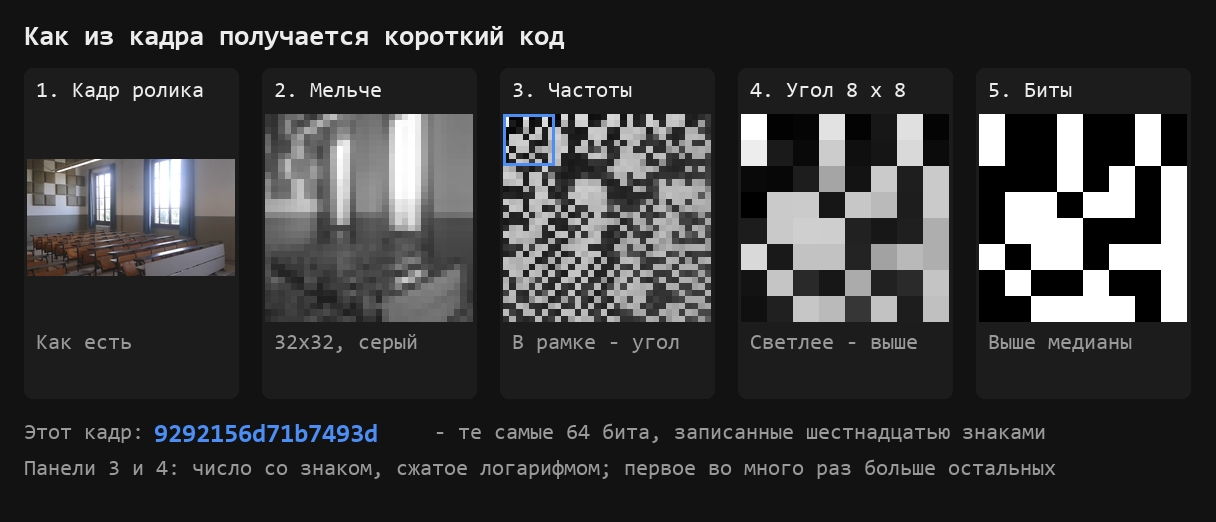
Разницу между двумя кодами выражают числом. Мы считаем расстояние Хэмминга: сколько битов из 64 разошлось. Ноль означает, что для алгоритма картинки неотличимы.
Авторы работы 7 померили устойчивость таких кодов на четверти миллиона изображений. Это случайная выборка из корпуса в миллион снимков. Пересжатие брали жёсткое: качество опускали до 30 процентов. Расстояние всё равно осталось почти нулевым. У всех пяти алгоритмов их итоговой таблицы расстояние вышло от 0,003 до 0,010 доли всех битов кода 7. Байты файла при пересжатии меняются, и хеш файла расходится. Перцептивный хеш почти не меняется.
Поворот такие коды переносят плохо. В работе 9 лучшим из четырёх алгоритмов оказался подсчёт средней яркости блоков. При пороге 0,3 он распознавал картинку, повёрнутую до трёх градусов. Замер там небольшой, на трёх снимках.
След 3: как узнают звук
Звуковые отпечатки считают отдельно от картинки. Как это делается, описано в открытых работах про распознавание музыки.
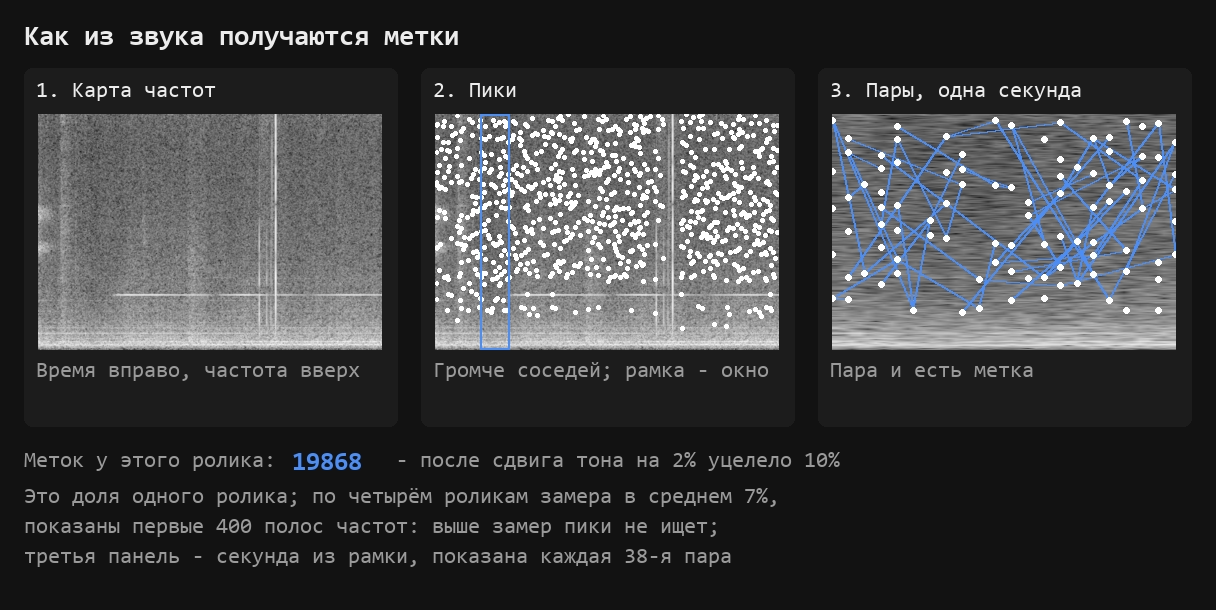
Сначала строят спектрограмму. Это карта частот по времени. На ней находят точки, которые громче своих соседей. Потом запоминают, как эти точки стоят друг относительно друга по времени. В нашем замере их берут парами, как в Audfprint. Тройками их берёт система Panako. Она рассчитана ещё и на сдвиг тона 4.
Сжатие таким отпечаткам почти не мешает. В одной из ранних опубликованных систем для опознания хватало трёх секунд звука. Трек в MP3 на 128 кбит/с узнавался уверенно 11.
Со скоростью важно, что именно ускорили. Запись можно проиграть быстрее целиком, вместе с тоном. Тогда та же система после ускорения на 4% теряла все четыре трека своего замера, хотя один из них потеряла едва-едва 11. Если меняли один темп, не трогая тон, треки узнавались 11. Система на парах точек, того же рода, что и наша, растяжение времени тоже переносила 4.
В нашем замере меняли именно темп, не трогая тон. После ускорения на 5% у нашего отпечатка осталось 13% меток. Мерили мы долю уцелевших меток, а не узнавание. Порога узнавания у нашего кода нет. А опубликованные системы узнают запись и по части меток, если их хватает. Поэтому 13% не значит, что ролик не узнают. Сказать можно другое. Ускорение и сдвиг тона уменьшают число меток сильнее всех остальных правок замера. Сдвиг тона больше чем на три процента Audfprint уже не переносил 4. О сдвиге на 2% в источнике данных нет.
След 4: сам аппарат
У каждой матрицы свой шум. По нему опознают не ролик, а снявший его аппарат. Набор VISION снят на 35 телефонах и планшетах. На нём такое опознание после загрузки на YouTube заметно слабеет. А после мессенджера — почти до уровня угадывания 16. Копии по этому следу, насколько известно, не ищут. Это инструмент криминалистики.
Вот все четыре следа разом.
| След | Чем меряется | Что его двигает | Чего не видит |
|---|---|---|---|
| 1. Байты файла | хеш файла; устройство контейнера MP4 6 | любая правка внутри файла; переименование его не двигает | содержимое: хеш узнаёт только точную копию, а по контейнеру 6 видны аппарат и пересборка, но не то, что в кадре |
| 2. Отпечаток картинки | расстояние из 64 битов | сильнее всего зеркало; заметно — рамка, обрезка, подпись; почти никак — пересжатие, шум, свет, ускорение | копию после зеркала: расстояние как у чужой картинки, около 32 битов 7 |
| 3. Отпечаток звука | доля уцелевших меток | сильнее всего сдвиг тона и ускорение; слабее — громкость | узнавание целиком: в замере считали долю уцелевших меток, а не то, найдёт ли система ролик |
| 4. Сам аппарат | площадь под кривой опознания, 0,50 — уровень угадывания | пересжатие при отправке: без него 0,94, после YouTube 0,77, после мессенджера 0,54 (съёмка без стабилизации) 16 | сам ролик: опознаёт аппарат, а не ролик; копии по нему, насколько известно, не ищут |
Числа по каждой правке для следов 2 и 3 — в разделе «Наш замер» ниже.
Content ID: что известно о сверке на YouTube
Правообладатель кладёт эталонный файл в базу. Новые загрузки сверяются с ней. При совпадении появляется заявка. Правообладатель выбирает одно из трёх: блокировать ролик, монетизировать его или смотреть статистику 5. Система ищет совпадения с базой аудио- и видеофайлов. Но ни алгоритма, ни порога совпадения справка не раскрывает 5.
Второй инструмент — поиск совпадений. Он ищет полные и почти полные копии ваших роликов на чужих каналах. Он сверяет картинку и звук и находит копию, даже если в ней заменили звуковую дорожку 23. Ограничения названы прямо. Проверяются только общедоступные видео. Часть трека совпадением не считается. Копия может не найтись, если вы загрузили видео не первым 23.
Функцию «Обнаружение сходства» по названию принимают за поиск копий. Но она защищает лицо автора от подделок, сделанных нейросетью 25.
Наш замер: что остаётся от отпечатков
Мы взяли четыре ролика с четырёх разных аппаратов, по двенадцать секунд каждый. Это настоящая съёмка с телефонов из открытого набора VISION 16. Эталоном служит не родной файл камеры, а его укороченная и один раз пересжатая копия. С ней и сравниваются все правки. Поэтому строка «перекодировали тем же кодеком» показывает второй проход кодировщика, а не первый.
К каждому ролику применили тринадцать правок. Большая часть — приёмы из подборок по уникализации. Три мы добавили как точки отсчёта. Это переименование, перекодировка тем же кодеком и прибавка громкости. После каждой правки посчитали три числа. Первое — хеш файла. Второе — перцептивный хеш по шестнадцати кадрам, снятым равномерно по длине самой копии. Третье — доля уцелевших меток звукового отпечатка.
Все правки делал ffmpeg, одними и теми же настройками. Картинку пересжимали кодеком H.264 с качеством crf 23. Звук — AAC 128 кбит/с. Шум — фильтр noise=alls=8:allf=t. Свет — eq=brightness=0.05:contrast=1.05. Ускорение — setpts=PTS/1.05 и atempo=1.05. Тон — rubberband=pitch=1.02. Зеркало — hflip. Обрезка — crop на 95% ширины и высоты. После этого кадр растягивали обратно до прежнего размера. Рамка — pad, 30 чёрных точек с каждой стороны. Подпись занимает десятую часть высоты кадра.
| Что сделали с роликом | Хеш файла | Отпечаток картинки | Уцелело меток звука |
|---|---|---|---|
| Переименовали файл | тот же | 0,00 | 100% |
| Стёрли и переписали метаданные | другой | 0,00 | 100% |
| Перекодировали тем же кодеком | другой | 0,25 | 70% |
| Наложили слабый шум | другой | 0,28 | 70% |
| Ускорили на 5% | другой | 0,69 | 13% |
| Осветлили кадр и подняли контраст на 5% | другой | 0,88 | 70% |
| Наложили подпись в углу кадра | другой | 2,97 | 70% |
| Обрезали по 2,5% с каждого края | другой | 5,53 | 70% |
| Добавили чёрную рамку 30 точек | другой | 9,88 | 70% |
| Отразили зеркально | другой | 31,34 | 70% |
| Сделали сразу шесть правок с теми же настройками | другой | 31,53 | 7% |
| Прибавили 2 дБ громкости | другой | картинку не трогали | 61% |
| Подняли тон звука на 2%, не трогая темп | другой | картинку не трогали | 7% |
В строке про шесть правок собраны зеркало, обрезка, свет, шум, громкость и сдвиг тона. Ускорения в ней нет. Поэтому 7% меток в последнем столбце — результат одного сдвига тона, а не всех правок вместе.
В столбце «Отпечаток картинки» стоит среднее по четырём роликам расстояние, из 64 возможных битов. Ноль означает, что для алгоритма картинка та же самая. Картинка остаётся побитово той же при копировании под другим именем, смене метаданных и двух звуковых правках. В этих случаях ноль ничего не говорит об устойчивости отпечатка. Кадр тот же. Поэтому у звуковых правок мы пишем «картинку не трогали». У переименования и метаданных ноль оставлен числом. Эти приёмы выдают за уникализацию, и ноль отвечает на вопрос, сдвинули ли они отпечаток.
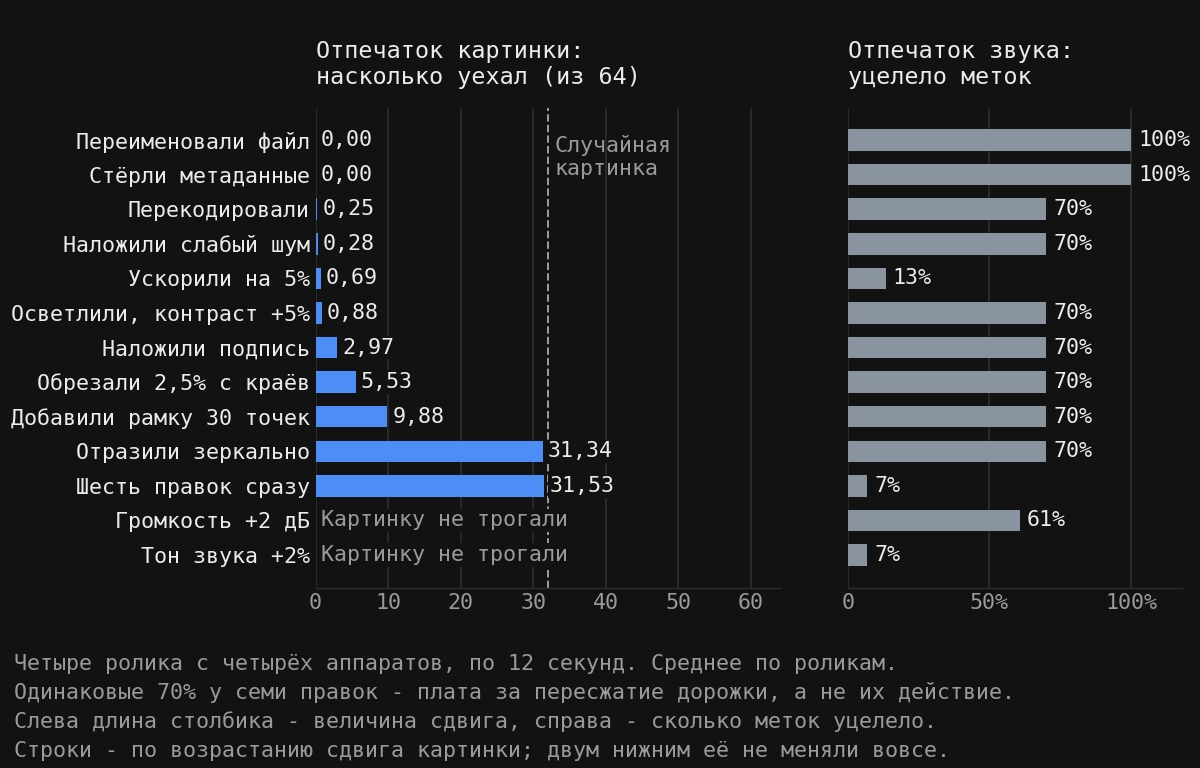
Одна оговорка про столбец звука. Около 70% стоит у всех правок, не касавшихся звука: перекодировки, шума, света, подписи, обрезки, рамки и зеркала. Это следствие пересжатия звуковой дорожки, а не действие правки. Уцелевшая доля по роликам — от 42% до 94%. Громкость отнимает сверх этого в среднем 9 пунктов. Но на двух роликах из четырёх она отняла 15 и 21 пункт.
Отсюда вывод, ради которого замер и делался. Отпечаток картинки двигает то, что меняет крупную структуру кадра. Это расположение содержимого и то, что лежит поверх него. Зеркало переставляет содержимое целиком и сдвигает отпечаток на 31,34 бита. Рамка расширяет кадр, обрезка сужает. Содержимое сдвигается относительно краёв: рамка сдвинула отпечаток на 9,88 бита, обрезка — на 5,53. Подпись закрывает часть картинки и сдвигает отпечаток на 2,97 бита. Слабый шум, пересжатие и лёгкая правка света структуру не трогают. В среднем они сдвигают отпечаток меньше чем на бит. Шум даёт 0,28, пересжатие 0,25, свет 0,88. На отдельных роликах бывало и больше, до 1,25 бита. Ускорение самих кадров не меняет. Оно сдвигает их во времени, отсюда 0,69.
Это следует из устройства алгоритма. Кадр уменьшают до 32 на 32 точки, то есть выбрасывают мелкие детали. Потом оставляют низкие частоты, то есть крупные пятна, и сравнивают каждую с медианой. Шум и пересжатие меняют мелкие детали. А их к этому моменту уже нет. Сдвиг яркости меняет только первое число, общую яркость кадра. Подъём контраста умножает все числа на одно и то же. Какое число выше медианы, а какое ниже, от этого почти не меняется. А подпись, рамка и зеркало меняют расположение крупных пятен. Это ровно то, что алгоритм сравнивает.
Подписи и рамки в замере сперва не было. Первые одиннадцать правок давали другой вывод: будто отпечаток двигает только геометрия кадра. В работе 7 на той же библиотеке и тех же 64 битах проверяли и водяной знак. Он сдвигает отпечаток на 7,85 бита, хотя кадр не двигает вовсе. Мы добавили подпись и рамку и повторили замер. Подпись дала 2,97. Геометрия прежняя, а отпечаток сдвинулся. Вывод пришлось переписать.
Рамка у авторов 7 сдвинула отпечаток сильнее обрезки: 17,0 против 10,8. У нас тоже: 9,88 против 5,53. Только обрезка у них снимала по 5% с каждого края, а у нас по 2,5%. Поэтому сами числа напрямую не сравниваются.
На звук это правило не переносится. Сдвиг тона картинку не трогает. А меток звука после него остаётся 7%. Ускорение картинку почти не двигает — 0,69 из 64. А от нашего звукового отпечатка оно оставляет 13%, с оговоркой из раздела про звук.
Метаданные не входят ни в отпечаток картинки, ни в отпечаток звука. Поэтому по этим двум следам их чистка ничего не меняет. Оговорка одна. Команда выше пересобирает контейнер. А по его устройству в работе 6 как раз видят, что файл пересобирали. Этот след мы не мерили.
В подборках про TikTok говорят то же, только без чисел. «Обычное изменение хэш-суммы файла (например, MD5 или SHA-256) не защищает видео от обнаружения, так как алгоритмы ByteDance анализируют именно картинку» 30. «Если менять один только хеш, оригинальным видео не станет» 31. Наш замер с этим согласуется. Он даёт число: меньше бита из 64. Что правила TikTok говорят о повторах в ленте, мы разобрали в статье про алгоритм тик ток.
Где этот замер не работает
Замер сделан 23 сентября 2026 года. Отпечаток картинки мы считали одним открытым алгоритмом. Это pHash, 64 бита, библиотека imagehash 32. Звук мы считали своим кодом. В нём пики спектрограммы берутся парами, как в Audfprint 4. Площадки своих алгоритмов не раскрывают. Наш результат на них не переносится.
В замере мы не использовали настройки нашей программы. Все правки сделаны фильтрами ffmpeg, перечисленными выше. В разделе про обработку мы связываем настройки программы с правками замера по названию.
С зеркалом нужна осторожность. Наш перцептивный хеш после зеркала даёт почти случайное расстояние. То же вышло у авторов 7 на четверти миллиона изображений. У двух популярных алгоритмов расстояние до отражённой копии — 0,49 и 0,50 доли при случайных 0,5. Но отсюда не следует, что площадка не узнает отражённый ролик. Она может сравнивать последовательность кадров и звук, а не один кадр. Об устройстве её сверки открытых данных нет.
Порог, при котором звук считается тем же самым, знает только площадка. Наш столбец меток показывает, сколько от отпечатка осталось, а не «совпало или нет».
И главное. Замер отвечает на вопрос «что осталось от отпечатка». Он не отвечает на вопрос «забанят или нет». Поведения площадки мы не мерили.
Четыре ролика по двенадцать секунд — слишком мало для статистики. Столбец картинки можно повторить на своём файле скриптом из раздела «С чего начать». Он снимает кадры равномерно по длине каждой копии, как и в замере. На нашем первом ролике он повторяет числа замера: рамка 12,00, зеркало 30,25, ускорение 1,25. В таблице выше стоят средние по четырём роликам. Фильтры правок перечислены в описании замера. Звуковой столбец скриптом не повторить.
Проверка видео на уникальность до публикации
Стороннего сервиса, который сверит ваш файл с отпечатком площадки, мы не нашли. Искали 23 сентября 2026 года. Смотрели выдачу по запросам о том, как площадка узнаёт копию видео. Отдельно искали по семи запросам вроде «проверить видео на уникальность онлайн» и «антиплагиат видео». Нашлись только сервисы, которые сравнивают варианты ролика между собой или уникализируют файл. Доступа к базе площадки у них нет. Проверить можно другое. Способов пять.
Проверка в YouTube Studio. Это единственная сверка с настоящей базой Content ID до публикации. Ролик загружают, не публикуя его, открывают вкладку «Проверки» и ждут результата. В ролике 35 он выглядит так: «авторские права: нарушений не найдено». Ищет она чужой контент внутри вашего ролика, а не ваш ролик среди чужих. Если вы не правообладатель в Content ID, вашего ролика в базе нет. И такой ответ не значит, что копию не узнают.
Unique Rate. Это наша бесплатная программа для Windows. Она сравнивает два видео, например исходник и копию после правок, и показывает оценку сходства. В этом замере мы её не использовали. Числа таблицы посчитаны перцептивным хешем. Что скажет площадка, не покажет ни она, ни любой другой сервис.
Свой перцептивный хеш. То же своими руками: открытая библиотека и скрипт из раздела «С чего начать». Он даёт число, которое можно сравнить с нашей таблицей.
Поиск по кадрам. Пару характерных кадров ищут в Яндекс Картинках или Google Картинках. Способ ручной. Поиск идёт по индексу поисковика, а не по базе площадки. Совпадение там не равно совпадению в Content ID.
Поиск по фразе из ролика. В поиск площадки вводят фразу, которая в ролике звучит. Способ тоже ручной. Работает только там, где в ролике есть разборчивая речь.
Поиск совпадений из раздела про Content ID сюда не относится. Он ищет копии ваших роликов среди уже опубликованных у других 23.
Про TikTok и Reels открытых описаний сверки нет. Замера сверки на этих площадках мы не делали. Замер значит для них то же, что для YouTube. Он показывает, что осталось от отпечатка файла. Как сверяет площадка, он не показывает.
Наш опыт в TikTok узкий. В сентябре 2026 года мы публиковали уникализированные копии на одном своём аккаунте. Трафик с него никуда не вёл: хотели только посмотреть, проходят ли такие ролики. Из семи копий шесть набрали от 123 до 202 просмотров, одна осталась на нуле. Устройства сверки это не показывает, только исход на одном аккаунте.
У каждого способа свой вопрос. Студия покажет, нет ли чужого внутри вашего ролика. Unique Rate и перцептивный хеш — насколько копия отличается от исходника. Поиск по кадрам и по фразе покажет, не лежит ли ролик уже где-то. Онлайн-просмотрщики метаданных и сервисы проверки хеш-суммы смотрят только байты файла. А байты в отпечатки картинки и звука не входят.
Отсюда и ответ про обещания продавцов. В подборках встречаются проценты: доля прошедших креативов и стопроцентная оригинальность. Долю прошедших можно посчитать только по своим рекламным кампаниям. Оригинальность в процентах не с чем сверить. Публичного порога у площадки нет. Проверяемо то, что вы меряете у себя. Изменился ли отпечаток картинки? Совпадают ли байты? Для меток звука нужен свой код, как у нас. Обещание «пройдёт проверку площадки» заранее не может подтвердить никто, кроме самой площадки.
Чем обрабатывать, если роликов много
Способов три. Они разной цены.
Командная строка. Бесплатно и под полным контролем. Каждая правка задаётся руками. Рецепты разобраны в статье «Уникализация видео через ffmpeg».
Видеоредактор. Понятный экран и очередь заданий, которую собирают вручную. На сотне роликов это часы работы.
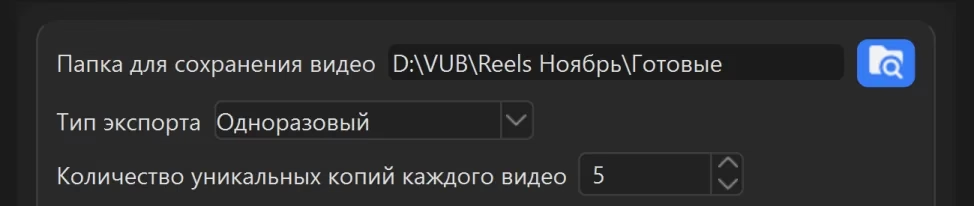
Программа с массовой обработкой. Настройка задаётся один раз на весь список выбранных файлов. Дальше работа идёт без вас. Как устроены такие программы, мы разбирали в статье про пакетную обработку видео. Наша программа такого рода — Video Unique Booster. В ней задаётся «Количество уникальных копий каждого видео». Из одного ролика выходит столько копий, сколько нужно. У каждой копии свои случайные значения настроек.
Правки из нашего замера там тоже есть. Действуют они по-разному:
- «Отзеркалить видео по горизонтали» — та же правка из замера. Она дала 31,34 из 64, сильнее всех одиночных правок по картинке.
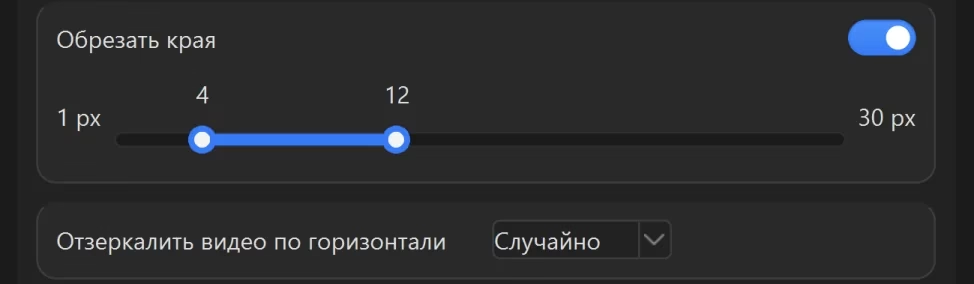
- «Обрезать края» — заметно слабее. В замере срез по 2,5% с края дал 5,53.
- «Изменить тон аудио» картинку не трогает. При сдвиге на 2% в замере осталось 7% меток звука.
- «Изменить длительность видео» ускоряет или замедляет ролик. Темп меняется, тон остаётся. Ускорение на 5% картинку почти не двигает. От нашего отпечатка звука оставляет 13%, с оговоркой из раздела про звук.
- «Добавлять метаданные» с готовыми наборами вроде «iPhone» не двигает ни одного отпечатка. Она меняет служебные записи внутри файла, то есть только первый след.
«Обрезать края» и «Изменить тон аудио» задаются диапазоном. Внутри него берётся случайное значение. У обрезки — отдельно для каждого края. Поэтому числа замера относятся к одной точке диапазона, а не ко всей настройке. «Отзеркалить видео по горизонтали» и «Добавлять метаданные» задаются списком значений.
Обрезка там считается пикселями, а не долей кадра. Сравнивать её с нашим замером надо осторожно. Шкала идёт от 1 до 30 точек. Для каждого края выбирается своё число. Их четыре, а не одно. У кадра 1920 на 1080 наши два с половиной процента — это 48 точек слева и справа. Но только 27 сверху и снизу. То есть по ширине верхний край шкалы, 30 точек, в 1,6 раза меньше 48 точек, которые мерились выше. А по высоте он, наоборот, чуть больше.
Выбирать приходится между своим временем и деньгами. Цены программы — на странице «Тарифы». Ни один способ не отменяет того, что показал замер. Отпечаток двигают правки, которые меняют крупную структуру кадра или сам звук.
Частые вопросы
С чего начать
Возьмите свой ролик и сделайте из него в папке kopii четыре файла. Первый — копия под другим именем, ничего больше. Второму почистите метаданные. Третьему обрежьте края. Команда ниже оставляет 95% кадра, то есть снимает по 2,5% с каждой стороны. В замере кадр после этого ещё растягивали до прежнего размера. На первом ролике замера с растяжением вышло 4,25 бита, без него 4,50. Четвёртый отразите зеркально.
mkdir kopii
copy video.mp4 kopii\kopiya.mp4
ffmpeg -i video.mp4 -map_metadata -1 -c copy kopii\clean.mp4
ffmpeg -i video.mp4 -vf "crop=iw*0.95:ih*0.95" -c:a copy kopii\crop.mp4
ffmpeg -i video.mp4 -vf hflip -c:a copy kopii\mirror.mp4
Посмотрите хеш файла у каждого. Имя файла подставляйте своё:
certutil -hashfile video.mp4 MD5
У копии под другим именем хеш совпадёт с исходником, у остальных разойдётся. Это первый след. Больше он ничего не показывает.
Теперь отпечаток картинки. Поставьте библиотеку один раз:
pip install imagehash
Сохраните рядом с роликом файл sravnit.py. Он снимает с каждого ролика 16 кадров равномерно по его длине. Потом считает перцептивный хеш каждого кадра и печатает среднее расстояние до исходника. Кадры берутся по длине самой копии, как в замере. Иначе у ускоренной копии сравнивались бы разные моменты съёмки.
import os, re, subprocess, sys, tempfile

import imagehash
from PIL import Image

FRAMES = 16


def hashes(video):
    info = subprocess.run(["ffmpeg", "-i", video, "-f", "null", "-"], capture_output=True, text=True, errors="replace").stderr
    hours, minutes, seconds = re.findall(r"time=(\d+):(\d+):([\d.]+)", info)[-1]
    length = int(hours) * 3600 + int(minutes) * 60 + float(seconds)
    result = []
    with tempfile.TemporaryDirectory() as folder:
        for index in range(1, FRAMES + 1):
            name = os.path.join(folder, f"kadr-{index:02d}.png")
            subprocess.run(["ffmpeg", "-loglevel", "error", "-ss", str(length * index / (FRAMES + 1)),
                            "-i", video, "-frames:v", "1", name], check=True)
            with Image.open(name) as frame:
                result.append(imagehash.phash(frame.convert("RGB")))
    return result


original = hashes(sys.argv[1])
for name in sorted(os.listdir(sys.argv[2])):
    if name.endswith(".mp4"):
        copy = hashes(os.path.join(sys.argv[2], name))
        distance = sum(a - b for a, b in zip(original, copy)) / FRAMES
        print(f"{name}: {distance:.2f} из 64")
Запустите его, указав исходник и папку с копиями:
python sravnit.py video.mp4 kopii
Скрипт сравнивает с исходником каждый ролик в папке. Поэтому он годится и для массовой проверки. Сложите в kopii сколько угодно копий, хоть сотню. Если первым передать не исходник, а одну из копий, он сравнит копии между собой. Вот что вышло у нас на первом ролике замера:
| Файл | Хеш файла | Отпечаток картинки, среднее по 16 кадрам |
|---|---|---|
| копия под другим именем | c99186ae…, как у исходника | 0,00 |
| метаданные стёрты | cb4549eb… | 0,00 |
| края обрезаны | a47b0645… | 4,50 |
| отражено зеркально | другой | 30,25 |
Чистка метаданных сделала файл другим по байтам. Отпечаток картинки она не сдвинула ни на один бит. Обрезка сдвинула, зеркало — сильнее всех. Хеш файла разошёлся у всех, кроме копии под другим именем. А о сходстве роликов по нему ничего не понять.
Дальше решайте по задаче.
- Повторно загружаете свой ролик на второй канал. Чистка метаданных и пересжатие отпечаток картинки почти не меняют. Это видно по таблице в разделе «Наш замер». Для вашего ролика Студия покажет только чужую музыку или чужие куски внутри. Узнают ли копию, она не покажет. Обрезку ради отпечатка делайте с оглядкой. Её видят зрители. А что решит площадка, не скажет ни один замер.
- Загружаете свои креативы десятками. Из правок, которые есть в Video Unique Booster, отпечаток картинки сильнее всего двигает зеркало. Обрезка двигает его слабее. Причём по ширине предел обрезки в программе меньше, чем в замере. Сдвиг тона сильнее всего уменьшает число меток нашего звукового отпечатка. Программа размножит ролик на нужное число копий с разными значениями этих настроек. А насколько каждая копия отличается от исходника, покажет скрипт выше. Сами настройки программы мы в замере не использовали. Числа относятся к тем же правкам, сделанным ffmpeg.
- Ролик чужой. Отпечаток сдвинуть можно. Но заявку по Content ID система создаёт по эталону правообладателя в базе. А что делать с совпадением, решает он 5.
Читайте по теме
- Как удалить метаданные с видео и что остаётся в файле
- Программа для пакетной обработки видео
- Уникализация видео для TikTok
- Как уникализировать видео для Ютуба
- Как уникализировать видео для Инстаграма
- Уникализация видео через ffmpeg
- Уникализация видео: онлайн-сервисы
- Уникализатор креативов: сто копий одного ролика
Источники
- Обсуждение «Перезалив своих же видео на другой канал». Searchengines.guru, 2023. ↩︎
- FFmpeg: страница загрузки. Официальный сайт проекта. ↩︎
- Ellis D. P. W. audfprint: Landmark-based audio fingerprinting. GitHub. ↩︎
- Six J., Leman M. Panako: A Scalable Acoustic Fingerprinting System Handling Time-Scale and Pitch Modification. ISMIR 2014. ↩︎
- Как работает Content ID. Справка YouTube. ↩︎
- Iuliani M., Shullani D., Fontani M., Meucci S., Piva A. A Video Forensic Framework for the Unsupervised Analysis of MP4-Like File Container. IEEE Transactions on Information Forensics and Security, 2018. ↩︎
- McKeown S., Buchanan W. J. Hamming Distributions of Popular Perceptual Hashing Techniques. Forensic Science International: Digital Investigation, том 44, 2023. ↩︎
- McKeown S., Buchanan W. J. Hamming Distributions of Popular Perceptual Hashing Techniques. Forensic Science International: Digital Investigation, том 44, 2023. ↩︎
- Zauner C. Implementation and Benchmarking of Perceptual Image Hash Functions. University of Applied Sciences Upper Austria, 2010. ↩︎
- Six J., Leman M. Panako: A Scalable Acoustic Fingerprinting System Handling Time-Scale and Pitch Modification. ISMIR 2014. ↩︎
- Haitsma J., Kalker T. A Highly Robust Audio Fingerprinting System. ISMIR 2002, Париж. ↩︎
- Haitsma J., Kalker T. A Highly Robust Audio Fingerprinting System. ISMIR 2002, Париж. ↩︎
- Haitsma J., Kalker T. A Highly Robust Audio Fingerprinting System. ISMIR 2002, Париж. ↩︎
- Six J., Leman M. Panako: A Scalable Acoustic Fingerprinting System Handling Time-Scale and Pitch Modification. ISMIR 2014. ↩︎
- Six J., Leman M. Panako: A Scalable Acoustic Fingerprinting System Handling Time-Scale and Pitch Modification. ISMIR 2014. ↩︎
- Shullani D., Fontani M., Iuliani M., Al Shaya O., Piva A. VISION: a Video and Image Dataset for Source Identification. EURASIP Journal on Information Security, 2017:15. ↩︎
- Iuliani M., Shullani D., Fontani M., Meucci S., Piva A. A Video Forensic Framework for the Unsupervised Analysis of MP4-Like File Container. IEEE Transactions on Information Forensics and Security, 2018. ↩︎
- Iuliani M., Shullani D., Fontani M., Meucci S., Piva A. A Video Forensic Framework for the Unsupervised Analysis of MP4-Like File Container. IEEE Transactions on Information Forensics and Security, 2018. ↩︎
- McKeown S., Buchanan W. J. Hamming Distributions of Popular Perceptual Hashing Techniques. Forensic Science International: Digital Investigation, том 44, 2023. ↩︎
- Shullani D., Fontani M., Iuliani M., Al Shaya O., Piva A. VISION: a Video and Image Dataset for Source Identification. EURASIP Journal on Information Security, 2017:15. ↩︎
- Как работает Content ID. Справка YouTube. ↩︎
- Как работает Content ID. Справка YouTube. ↩︎
- Инструмент поиска совпадений. Справка YouTube. ↩︎
- Инструмент поиска совпадений. Справка YouTube. ↩︎
- Обнаружение сходства. Справка YouTube. ↩︎
- Shullani D., Fontani M., Iuliani M., Al Shaya O., Piva A. VISION: a Video and Image Dataset for Source Identification. EURASIP Journal on Information Security, 2017:15. ↩︎
- McKeown S., Buchanan W. J. Hamming Distributions of Popular Perceptual Hashing Techniques. Forensic Science International: Digital Investigation, том 44, 2023. ↩︎
- McKeown S., Buchanan W. J. Hamming Distributions of Popular Perceptual Hashing Techniques. Forensic Science International: Digital Investigation, том 44, 2023. ↩︎
- Iuliani M., Shullani D., Fontani M., Meucci S., Piva A. A Video Forensic Framework for the Unsupervised Analysis of MP4-Like File Container. IEEE Transactions on Information Forensics and Security, 2018. ↩︎
- Как обойти алгоритмы Video Frame Hash Deduplication в TikTok. PR Motion. ↩︎
- Уникализация фото и видео. Partnerkin. ↩︎
- imagehash: библиотека перцептивных хешей. PyPI. ↩︎
- Six J., Leman M. Panako: A Scalable Acoustic Fingerprinting System Handling Time-Scale and Pitch Modification. ISMIR 2014. ↩︎
- McKeown S., Buchanan W. J. Hamming Distributions of Popular Perceptual Hashing Techniques. Forensic Science International: Digital Investigation, том 44, 2023. ↩︎
- Как проверить видео на авторские права. Проверка видео на уникальность. Captain computer, YouTube. ↩︎
- Инструмент поиска совпадений. Справка YouTube. ↩︎
- Как работает Content ID. Справка YouTube. ↩︎