У вас один рабочий ролик. И тридцать аккаунтов под залив. Вы заливаете один и тот же файл. Часть аккаунтов собирает нули. Часть уходит в реджект. На тесте связка давала лид. На объёме перестала.
Дальше начинается перебор. Пропустить через бота. Накинуть фильтр. Почистить метаданные. Работает это через раз. Советы из ниши не объясняют, почему именно через раз.
Короткий ответ вперёд. Чистка метаданных не влияет вовсе на то, узнает ли площадка копию. Метаданных нет в кадре, а площадка сравнивает кадр. Дальше - числа из замеров: насколько каждая операция двигает отпечаток. И наша оценка предела, за которым копия начинает выглядеть испорченной. Это оценка, а не замер, и в таблице так и помечено.
Для кого эта статья и кому она не нужна
Она нужна байеру. Тому, кто льёт с нескольких аккаунтов и готовит крео пачками. И тому, кто развозит один ролик по донорским каналам.
Если аккаунт один и оффер один, всё это вам пока не нужно. Снять второй ролик дешевле, чем разбираться с отпечатками.
Ещё одна отсечка. Здесь не будет обещания обойти модерацию. Такое обещание дают многие: один из сервисов заявляет «99% успеха». Доказательств не приводит никто, и это не случайность: модерация смотрит на содержимое объявления, а обработка файла его не меняет. Разобрано ниже, в разделе «Чего уникализация не делает».
Уникализатор видео для Windows: сотни копий за запускВручную Вы правите копию за копией. Программа создаёт их пачкой. У каждой свои картинка, звук, метаданные и длительность.
Уникализатор видео Video Unique Booster для WindowsВы кладёте видео и задаёте диапазоны настроек. Программа создаёт сотни копий. У каждой свои картинка, звук и длительность.
Уникализатор видео: сотни копий из одного оригиналаРучной способ упирается в одно. Каждую копию надо править отдельно. Больше копий - больше времени.
Уникализатор видео для TikTok, YouTube и InstagramДиапазоны настроек Вы задаёте один раз. Дальше программа для Windows создаёт копии пачкой. Сотнями за запуск.
Уникализатор видео для Windows - Video Unique BoosterВы добавляете одно видео. Программа создаёт сотни копий. У каждой свои картинка, звук, метаданные и длительность.
Три уровня проверки сходства, из которых обсуждают обычно один
«Facebook спалит перезалив» - за этой фразой стоят три механизма. Устроены они по-разному. И на обработку реагируют неодинаково.
Уровень 1. Точное совпадение файла. Считается криптографическая контрольная сумма. Её меняет один-единственный бит. Пересохранили файл - сумма другая. Этот уровень обходится любой операцией. Поэтому на нём никто не останавливается.
Уровень 2. Приблизительное совпадение по байтам. Для медиафайлов он негоден. В работе McKeown и Buchanan 1 сказано прямым текстом: смена параметров кодирования даёт совершенно другое двоичное содержимое. Картинка при этом та же самая.
Уровень 3. Перцептивный отпечаток. На этом уровне и работают площадки. Кадр переводят в яркость. Усредняют. Ужимают до грубой сетки - у алгоритма PDQ это 64 точки по стороне. Из неё считают короткий отпечаток. Сравниваются не файлы. Сравнивается то, как кадр выглядит.
Отсюда следует вывод, который держит всю остальную статью. Имя кодека, контейнер, частота кадров и разрешение в перцептивный отпечаток не входят. Это не догадка. У Meta есть открытый алгоритм поиска копий видео - TMK+PDQF 6. В его техническом описании это сказано дословно. Алгоритм находит визуально одинаковые ролики при разной частоте кадров. И при разном формате файла. И при разном разрешении.
И сразу оговорка, без которой это утверждение было бы шире замера. Открытый алгоритм Meta описывает розыск копий контента, а не проверку сходства креативов внутри рекламного кабинета. Как именно дедуплицируют крео Meta Ads и TikTok Ads, какие у них пороги, публично не пишет никто. Мы тоже этого не знаем и делать вид не будем.
Что меняет отпечаток, а что нет: числа из замеров
Опорный открытый замер по этой теме - работа McKeown и Buchanan 2023 года 1. Набор Flickr в миллион изображений, около 50 миллионов случайных парных сравнений. Изменения внесены в подвыборку из 250 тысяч картинок, набранную жребием. Шесть алгоритмов. Семь видов изменений. Работа даёт готовую шкалу.
В таблице - нормированное расстояние между двумя отпечатками. Между оригиналом и изменённой копией. Ноль означает «отпечаток тот же самый». Ориентир сверху: у двух случайных, никак не связанных картинок расстояние выходит 0,49-0,50. У каждого отпечатка своя такая величина: у NeuralHash, который появится ниже, это 0,4973.
И ориентир снизу, без которого таблица не читается. В техническом описании PDQ 6 сказано, что порог задаёт тот, кто строит систему, а хорошие результаты давали расстояния 30, 20 и меньше. Возьмём верхнюю величину - 30 из 256, то есть около 0,117. Сама Meta в своих замерах берёт чуть больше, 32, и это 0,125 - на выводы ниже разница не влияет. При более строгой настройке порог ниже, и приёмы на границе перестают проходить. Для алгоритма копия со сдвигом меньше порога - всё ещё тот же самый кадр. Копия со сдвигом больше порога - уже другой кадр.
| Что сделали с картинкой | pHash | PDQ | Что это значит на практике |
|---|---|---|---|
| Пережали в JPEG с качеством 30 | 0,0053 | 0,0094 | у pHash 83,9% отпечатков совпали бит в бит |
| Увеличили в 1,5 раза | 0,0020 | 0,0237 | у pHash 94,0% отпечатков совпали бит в бит |
| Наложили водяной знак в 10% высоты | 0,1227 | 0,1029 | порог не перешагнут: для PDQ это всё ещё тот же кадр |
| Обрезали по 5% с каждой стороны | 0,1686 | 0,3255 | бит в бит совпали 0,04% отпечатков у pHash и 0% у PDQ |
| Добавили чёрную рамку 30 px | 0,2656 | 0,3949 | бит в бит не совпал ни один отпечаток; рамка задана в пикселях, а не в долях кадра |
| Отразили по оси x - так это названо в работе | 0,4904 | 0,4975 | <td>сдвиг такой же, как у чужой картинки</td>
Две строки тут стоят всего остального.
Первая из них - верхняя строка, пережатие в JPEG с качеством 30. Пережать файл сильнее некуда. Качество JPEG 30 - это уже видимые квадраты. И при этом у pHash 84 отпечатка из 100 остались абсолютно теми же. У PDQ 23 из 100. Для такого разрушения картинки это тоже много. Вывод авторов дословно: «все алгоритмы прекрасно справились и с плохим качеством JPEG».
Причина простая. Отпечаток считается по тому, как кадр выглядит. После перекодирования кадр выглядит так же.
Вторая - нижняя строка, с отражением кадра. Отражение по горизонтали уводит отпечаток туда, где лежат посторонние изображения. Для алгоритма зеркальная копия - это другая картинка. Авторы пишут: отражение сбивает отпечаток сильнее всего, рамка идёт второй.
Есть ещё одно неожиданное число. Его дал замер Штруппека и соавторов 2022 года 2 по нейросетевому отпечатку NeuralHash. Поворот на один градус меняет больше 5% битов отпечатка. Сжатие в JPEG меняет около 2%. В работе стоит сила сжатия 92 из 100 по шкале библиотеки imgaug, и авторы называют получившееся качество картинки приемлемым. Поворот на градус человек не заметит. Отпечаток сдвигается от него сильнее, чем от такого перекодирования.
В той же работе нашлась асимметрия, которой в советах ниши нет. Двукратное увеличение контраста меняет 37% битов, яркости - 22%. Уменьшение вдвое не даёт почти ничего. Тянуть ползунок вверх и вниз - не одно и то же.
Метаданных в этой таблице нет, и это не упущение
Перечень операций есть на восьми страницах из десяти, которые мы разобрали по запросу «уникализатор креативов». В другом разборе, по обсуждениям и роликам, видно и порядок: чистка метаданных стоит там первым пунктом. В роликах её показывают так же. Открыли, почистили, готово.
А перцептивный отпечаток считается по пикселям. Метаданных в кадре нет: в эту сетку они не попадают и на расстояние между отпечатками не влияют.
Мы искали работы, где смена метаданных сдвигала бы перцептивное сходство. Не нашли ни одной - ни в OpenAlex, ни в arXiv, ни в описаниях самих площадок.
Это стыкуется с нашим замером. Мы пропустили через одну методику тринадцать ботов-уникализаторов. Шесть из них метаданные чистят, семь не трогают. У тех, что чистят, дата создания чаще всего выходит битой - вместо значения нули. Значимых изменений в кадре не внёс ни один.
Метаданные и правда относятся к проверке сходства. К первому её уровню из трёх. Они меняют точную сумму файла и влияют на служебные сверки площадки. Но «алгоритм узнал перезалив» - это про третий уровень. Метаданные до этого уровня не доходят. Трогать их стоит по другой причине: одинаковые служебные поля у сотни файлов - это готовый признак пачки для любой сверки, которая смотрит не на кадр. Отпечатка это не двигает, и уникализацией не считается.
Операции, их цена и безопасные пределы
Вторая таблица отвечает на вопрос, которого не задаёт ни одна из разобранных страниц. Насколько каждая операция сдвигает отпечаток. И чем за это платите.
Колонка «Сдвиг отпечатка» собрана из двух замеров, и путать их нельзя. Доли вида 0,49 - это замер pHash и PDQ из работы McKeown. Проценты битов - замер нейросетевого отпечатка NeuralHash из работы Штруппека. Величина у них одна и та же: доля различающихся битов, шкала от нуля до единицы. Разные у них алгоритмы. У pHash отпечаток длиной 64 бита, у PDQ 256, у NeuralHash 96, и порог решения у каждого свой.
Насколько разница алгоритмов меняет число, видно на отражении. У pHash отражение даёт 0,49, у PDQ 0,50 - ровно столько же, сколько у чужой картинки. У NeuralHash то же отражение даёт 0,29. Операция одна, шкала одна, алгоритмы разные. Поэтому сравнивать имеет смысл только внутри одного замера.
| Операция | Сдвиг отпечатка | Чем рискуете | Разумный предел |
|---|---|---|---|
| Отражение по горизонтали (pHash, PDQ) | 0,49 - как у чужого кадра | текст и логотипы в кадре читаются задом наперёд | один раз, если в кадре нет надписей |
| Чёрная рамка или поля (pHash, PDQ) | 0,27-0,39, но замер сделан на рамке в 30 px, добавленной снаружи кадра; настройка в программе закрашивает край внутри кадра и его не расширяет, и своего числа под ней нет | уменьшает полезную площадь кадра, в ленте выглядит дёшево | до 50 px - больше поле настройки в программе не принимает |
| Обрезка краёв (pHash, PDQ) | 0,17-0,33 | обрезает подписи и лица по краям | 10-25 px с каждой стороны, больше 30 px поле настройки в программе не принимает |
| Поворот (NeuralHash) | больше 5% битов на 1 градус, но замер сделан на повороте, который добавляет в кадр чёрные клинья, а работа прямо говорит, что отпечаток сильнее всего меняет именно потеря или добавление картинки; настройка в программе клиньев не оставляет, и своего числа под ней нет | чёрных углов не оставляет: программа увеличивает кадр перед поворотом и обрезает обратно, так что по краям теряется немного картинки | 1-2 градуса: поле настройки в программе принимает только целые числа |
| Водяной знак или наложение (pHash, PDQ) | 0,10 у PDQ - ниже его порога; 0,12 у pHash, а его порога мы не знаем | чужой знак в кадре недопустим, свой узнаваем | 8-12% высоты и только свой знак, но как самостоятельный приём он не годится: порог PDQ он не перешагивает |
| Изменение длительности | двигает временную ось; звуковой отпечаток классической схемы переживает растяжение времени 5 | на сильном растяжении речь слышно меняется, замера этого порога у нас нет | 3-8% |
| Масштаб (pHash, PDQ) | 0,002-0,024, замер на обычном увеличении картинки в полтора раза; настройка в программе работает иначе - увеличенный передний план ложится поверх размытого фона, а размер кадра остаётся прежним, так что это число не про неё | почти ничего не даёт | как дополнение, не как основа |
| Насыщенность (NeuralHash) | 1-2% битов | почти ничего не даёт | как дополнение |
| Яркость и контраст (NeuralHash) | 22-37% битов, но замер сделан на двукратном изменении | пересвет виден глазом | 5-15%, и что даёт этот предел - никто не мерил |
| Шум | зависит от силы | много шума портит отклик | слабый, поверх кадра |
| Перекодирование, битрейт, кодек | около нуля | тратит время впустую | как самостоятельный приём не годится |
| Чистка метаданных | ноль на третьем уровне | создаёт ложное чувство сделанной работы | делать, но не считать уникализацией |
Колонка «Сдвиг отпечатка» - числа из двух замеров, 1 и 2: какой где, сказано перед таблицей. Колонка «Разумный предел» - наша оценка по риску испортить кадр, а не замер: числа в ней не мерил никто, включая нас.
Две нижние строки - это те самые операции, которые в нише советуют чаще прочих.
Спор про звук, который решается числами
Про звук в роликах по теме сказано противоположное. В одном говорят так: звук можно не трогать, соцсети сами разрешают брать чужие дорожки. В двух других настаивают на обратном. Звук обрабатывать обязательно, вплоть до смены голоса и подмешивания шума.
Отчасти правы обе стороны. Вот как это выглядит в замерах.
Звуковой отпечаток к шуму почти равнодушен. Ванг в работе 2003 года 4 описал алгоритм Shazam. Половина пятнадцатисекундных фрагментов опознаётся даже при отношении сигнал-шум минус 9 децибел. То есть когда шум громче музыки. Перекодирование в GSM сдвигает эту точку до минус 3 децибел - и только. Подмешивать шум в дорожку ради уникализации бессмысленно.
А со скоростью тоньше, чем кажется. Сикс и Леман измерили это в работе 2014 года 5. Мерили они Audfprint - открытую реализацию той самой схемы Ванга, а не сам Shazam, и дальше речь про неё. Схема не восстанавливается после сдвига высоты тона больше чем на 3% и разваливается там, где меняются сразу высота и время. А чистое растяжение времени - темп другой, высота прежняя - схема переживает: «Audfprint неожиданно устойчив к растяжению времени», пишут авторы. Настройка длительности в программе делает ровно это: тянет картинку и вместе с ней звук, оставляя высоту голоса. Значит, по звуковому отпечатку она почти не бьёт, и мишень у неё одна - временная ось видео.
Одна операция не спасает, и это тоже посчитано
С декабря 2022 по апрель 2023 года Meta провела открытое соревнование по поиску копий видео 3. Копии для него делали цепочкой из двух-пяти преобразований. Цвет, наложения, склейка двух роликов, размытие, шум, пикселизация, обрезка, поля, поворот, отражение, соотношение сторон, масштаб, качество кодирования, изменение скорости, прореживание кадров, повтор скопированного куска, вставка в скриншот, сетка, перспектива, тряска.
Победитель показал на этих копиях 87,2% по метрике micro-AP - на том треке, где надо было описать копию отпечатком. На втором треке, где её надо было сопоставить с оригиналом, он же взял 91,5%. Это не «нашли 87 копий из ста»: метрика считает качество ранжирования, а не долю найденного. Но порядок величины она задаёт ясно.
Отсюда два вывода. Первый: против современного детектора одной операции мало, нужна цепочка. Оговорка обязательна. Одиночные операции в этом соревновании не мерили вовсе. А в замере по картинкам одно зеркало уводит отпечаток дальше всех. Второй: цепочка тоже не даёт невидимости. Вам обещают обход? Значит, этих чисел не читали. Или рассчитывают, что их не читали вы.
Ниша советует как раз ту половину операций, которая работает хуже
В той же работе преобразования разобраны по трудности. Считают так. Берут все копии, в цепочку которых попало это преобразование. Смотрят, как детектор с ними справился. То есть это трудность преобразования в составе цепочки, а не в одиночку.
Легче всего детектору даются правки по времени. Авторы называют их поимённо: изменение скорости и повтор скопированного куска. Причина в устройстве решений-участников. Почти все они строились на признаках отдельного кадра, а временную ось такие признаки не используют. Так делали не все: у одного из призёров признак был и временной, а победитель второго трека оценивал, как копию растянули во времени. Но правилом это не стало.
Труднее всего даётся смешивание кадров из разных роликов. Рядом стоит геометрия, которая добавляет или убирает площадь кадра. Это вставка в скриншот и обрезка.
Теперь сверьте это с тем, что советуют в роликах и статьях по теме. Скорость, зеркало, чёрно-белый фильтр, масштаб, надпись поверх - все в лёгкой половине списка. Склейка с чужим материалом и обрезка - в трудной. Ниша советует ровно ту половину, которая детектору даётся легче.
И да, зеркало попало в лёгкую половину. Противоречия с таблицей выше нет. Зеркало полностью меняет простой отпечаток вроде pHash. Обученный детектор копий его узнаёт. Это разные системы. Путать их - главная ошибка в этой теме.
Оговорка та же, что и выше. Это замер про розыск копий контента, а не про дедупликацию в рекламном кабинете. Порядок трудности он задаёт, но приговора не выносит.
Чего уникализация не делает
Три границы, которые стоит проговорить до инструкции.
Она не гарантирует, что креатив пройдёт модерацию. Модерация смотрит на содержимое объявления. Вопрос «видела ли я этот файл раньше» там не единственный. Откровенный креатив останется откровенным после любой обработки.
Она не лечит аккаунт. Судьба рекламного аккаунта складывается из прогрева, прокси, платёжки, истории и поведения. Креатив там - одна из переменных. В одной из веток профильного форума один из практиков описывает периоды массовых чисток агентских кабинетов. Доля мгновенных банов там называется большой, но это оценка одного человека, а не замер, поэтому числа мы не приводим. Важно тут другое, и это подтверждает весь разбор: решает не файл.
Она не скрывает заимствованный контент от правообладателя. Google пишет об этом открытым текстом в отчёте о борьбе с пиратством 7. Content ID умеет ловить попытки уйти от обнаружения. В их числе смена соотношения сторон, отражение по горизонтали, ускорение и замедление звука - ровно те приёмы, которые меняют перцептивный отпечаток рекламной дедупликации. То есть система построена именно под них. И работает она не на пробных объёмах: на странице правил самого YouTube сказано, что за 2024 год Content ID выдал больше двух миллиардов претензий и оспорено меньше процента из них.
Уникализация разводит ваши собственные креативы между собой. Розыск чужого контента она не отменяет.
Ручной путь: девять шагов на каждую копию
Так это выглядит без инструментов. Ровно так, как показывают в роликах.
- Открыть ролик в мобильном или настольном редакторе.
- Поменять скорость на 1,05-1,10.
- Отразить кадр, если в нём нет надписей.
- Сдвинуть цветокоррекцию: температуру на 2-3 деления, экспозицию на единицу, контраст на 2-3.
- Обрезать по краям и добавить поля.
- Наложить свой знак или сетку.
- Выгрузить.
- Почистить метаданные отдельным инструментом.
- Повторить с другими значениями для следующей копии.
Сколько занимает ручной цикл в редакторе, не меряет никто. Числа времени в роликах встречаются - «за 10 минут» на разбор трёх способов, «примерно 20 минут» на создание готового ролика, - но это время одного показа, а не цикла на сотню копий. Поэтому числа не выдумываем: посчитайте свой цикл сами. Девять шагов на копию, и значения нельзя повторять от копии к копии, иначе смысл теряется. Умножьте на сто. Столько ручной работы обычно и не делают - ради этого массовый режим и существует.
Именно поэтому вся ниша сидит на ботах. И именно поэтому упирается в их потолок.
Почему бот упирается в потолок
Соберём в одном месте то, что сегодня предлагают по запросу «уникализатор креативов».
| Решение | Лимит | Размер файла | Обработка папки | Цена |
|---|---|---|---|---|
| Веб-уникализатор profitweb.tools, гостевой доступ | 5 креативов в сутки | до 10 МБ | нет | бесплатно |
| Он же, после регистрации | 20 креативов в сутки | до 50 МБ | нет | бесплатно |
| Telegram-бот Shinobi, оплата за файл | предела нет, платите за каждый файл | до 170 МБ | нет | около 0,2 $ за видео |
| Telegram-бот Unikcreo, подписка | есть бесплатный лимит | не опубликован | нет | 199 руб. в месяц |
| ImgFactory, веб-сервис для картинок | 20 изображений в сутки | - | нет | дальше 10-30 копеек за копию; видео не обрабатывает |
| Бот Apps4you | 5 бесплатных обработок | не опубликован | нет | цена не опубликована |
| Настольная программа, локальный режим | без суточного лимита на платной лицензии; на тесте предел есть, и его число программа показывает прямо в своей панели | предела загрузки нет: файл с диска не уходит | да, папку целиком | от 39 € в неделю, тест бесплатный |
Ни одно из чужих решений в этой таблице не обрабатывает папку целиком. Один из разборов в теме так и советует: запустите бота пять-двадцать раз руками. Двадцать файлов в сутки при пределе в 50 МБ - это не залив. Это проба.
Этот потолок мы проходили сами. До своей программы мы пробовали онлайн-уникализаторы, и большую сетку аккаунтов они не обслуживали: от силы два десятка уникальных версий, дальше предел.
Отдельная ловушка размера. Предел 10 МБ отсекает как раз рабочие креативы. Мы померили битрейт на своём наборе съёмки с телефонов - 683 ролика Full HD с трёх десятков аппаратов: медиана 10,8 мегабита в секунду, то есть минута весит около 81 МБ. Даже если пережать вчетверо, минута выйдет около 20 МБ и в предел не влезет никак.
Сколько стоит сто копий одного крео
Цены разбросаны по всем страницам выдачи. Арифметики нет ни на одной. Сведём.
| Способ | Сто копий одного ролика | Что ещё тратится |
|---|---|---|
| Бот с оплатой за файл, 0,2 $ за видео | около 20 $ | по одному файлу, руками |
| Подписка 199 руб. в месяц | 199 руб. в пределах лимитов подписки | упирается в лимиты подписки, предел размера не опубликован |
| Руками в редакторе | 0 руб. | девять шагов на копию, то есть девятьсот шагов на сотню; своего замера времени у нас нет |
| Свой скрипт на арендованном сервере | от 45 руб. по промо-тарифу с урезанными возможностями | несколько вечеров на настройку |
| Настольная программа, вся папка за запуск | 39 € за неделю, 99 € за месяц, 2999 € пожизненно | минуты на обработку |
Последняя строка - про нас. Video Unique Booster - наш продукт, и блог этот тоже наш. Поэтому числа в его строке не взяты из головы: их видно на странице тарифов. Локальная обработка кредитов не тратит, но в число доступных видео засчитывается наравне с облачной. Сколько всего доступно на тестовом ключе, показывает панель баланса в самой программе, и этого хватает, чтобы проверить диапазоны на своём ролике до оплаты.
Строка про свой скрипт требует пояснения. Цену такого пути обычно не считают вовсе.
Путь этот мы знаем по роликам, где его показывают, - своего опыта тут у нас нет, и ни скрипт, ни хостинг авторы не называют. Авторы честно проходят через аренду сервера. Потом через загрузку файлов. Потом через правку пределов загрузки в настройках. Там стоит ловушка. Предел по умолчанию - 2 МБ. Видео крупнее просто не обрабатывается. Результат выходит пустым, и ни одной ошибки нет. Плюс отладка. Бесплатным такой путь выглядит только в пересчёте на деньги.
Чей сервер видит вашу связку
Есть довод, которого нет ни в одном из разобранных материалов выдачи.
Все чужие решения из таблицы выше - это боты и веб-сервисы. Ваш креатив загружается на чужой сервер. Вместе с ним туда уезжает всё, что в нём видно. Оффер. Подача. Гео. Язык. Имя приложения. Номер потока в ссылке, если он попал в кадр. Смотрит ли владелец бота на загруженное, мы не знаем и проверить не можем. Знаем другое: технически ему ничто не мешает.
У настольной программы тут есть то, чего у бота нет вовсе: выбор. Video Unique Booster в локальном режиме считает кадры на процессоре вашей машины: сам видеофайл с диска никуда не передаётся. Наверх передаются настройки обработки, сведения о ролике и пути файлов: из них сервер собирает команду. Поэтому имя файла держите таким же нейтральным, как и всё остальное. Облачный режим в программе тоже есть. Он как раз отправляет видео на сервер. Но это ваше решение, а не условие работы. У бота выбора нет: файл придётся отдать всегда.
Второе отличие - объём за один запуск. Программа берёт папку целиком, бот - по одному файлу.
Так мы и работали с сеткой Reels в Instagram: около 300 аккаунтов, по три ролика в сутки с каждого. Обрабатывали мы их только всей папкой, ни разу по одному. Наша программа складывала готовые копии в папку, а приложение для управления аккаунтами брало ролики на публикацию из неё же.
Как получить сто копий за один запуск
Шаг 1. Добавьте исходные ролики
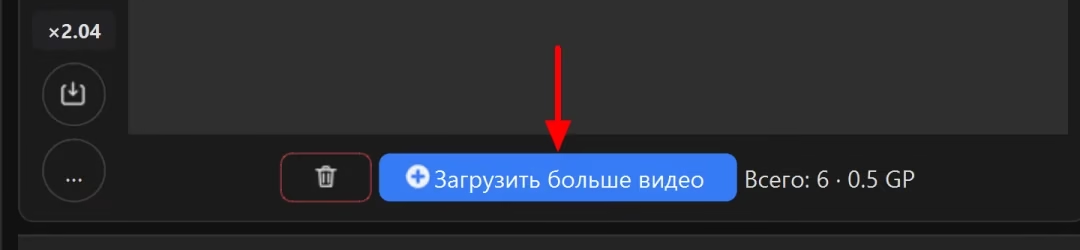
Файлы добавляются кнопкой «Загрузить больше видео» под списком загруженных роликов, а папка целиком - переносом мышью прямо в список.
Дальше на кадрах - служебные ролики: горизонтальные, по три секунды, залитые цветными переходами вместо картинки. На их месте у вас будут свои вертикальные креативы.
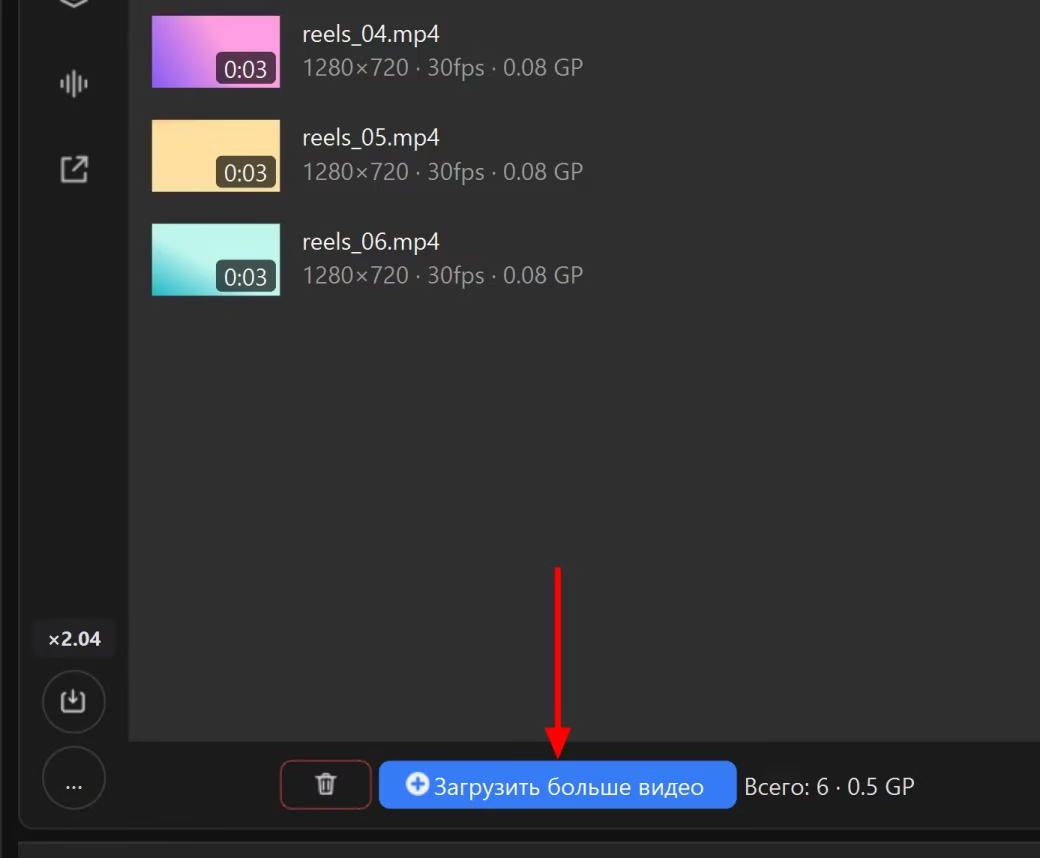
Под каждым именем программа пишет разрешение, частоту кадров и объём в гигапикселях - GP. Это мера работы: чем крупнее кадр, чем чаще кадры и чем длиннее ролик, тем она выше. От неё считается стоимость облачной обработки, но не от неё одной: в счёт входит ещё сложность проекта, и её множитель программа показывает отдельной плашкой.
Шаг 2. Задайте число копий на каждый ролик
Настройка называется «Количество уникальных копий каждого видео» и живёт в разделе «Экспорт». Раздел открывается в два движения: значок вывода в левой полосе, затем пункт «Экспорт» в выехавшей панели.
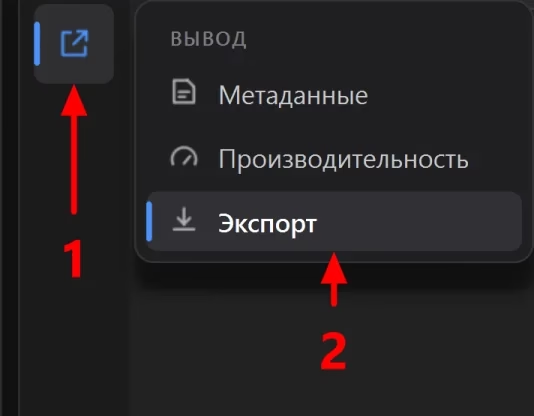
Сотня копий - это одно число в одном поле, а не сто запусков.
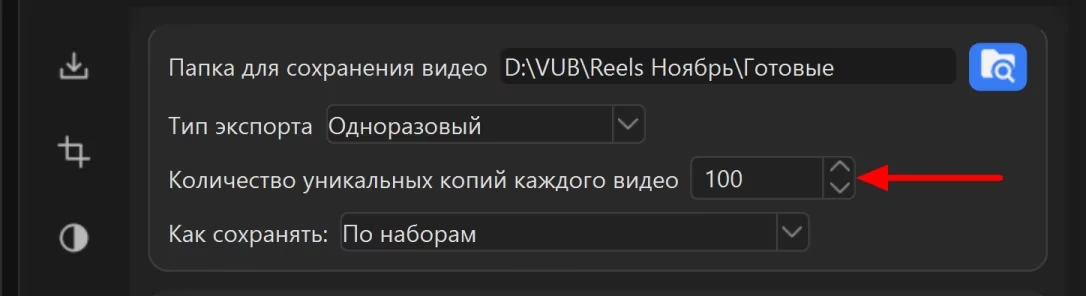
В той же карточке стоят ещё две настройки, и обе отвечают на вопросы, которые возникнут сразу после запуска. «Тип экспорта: Одноразовый» значит «сделать заказанное число копий и остановиться»; соседние режимы работают иначе - поддерживают в папке заданное число видео или проверяют источники по расписанию. «Как сохранять: По наборам» складывает готовое в папку VUB_result_<дата_время>. Внутри неё программа делает по папке на копию - pack0, pack1 и дальше; при ста копиях их будет сто. В каждой лежит по одной копии каждого ролика, то есть готовый набор на аккаунт.
Шаг 3. Выставьте диапазоны, а не фиксированные значения
Каждая копия возьмёт своё случайное значение внутри диапазона. Тогда копии отличаются и от оригинала, и друг от друга. Одно фиксированное число даёт сто одинаковых копий, и смысл обработки теряется.
Начните с отражения по горизонтали: по числам из таблицы выше оно двигает простой отпечаток сильнее всего. Выбирается оно не галочкой, а из трёх пунктов: «Нет», «Всегда» и «Случайно». «Всегда» отражает каждую копию, «Случайно» решает это для каждой отдельно: примерно половина останется без отражения, зато копии будут отличаться ещё и этим. Смотрите только, нет ли в кадре надписей и лиц в профиль: зеркальный текст читается как брак, и тогда отражение придётся снять. Оговорка та же, что и выше: обученному детектору копий отражение даётся легко.
Следом включите рамку. В списке она не соседняя: между ней и отражением лежат три выключенные карточки. Задаётся она диапазоном толщины: на кадре ниже стоит от 2 до 6 px - шкала в приложении подписана именно так. И помните, что число в таблице измерено на рамке снаружи кадра, а эта закрашивает край внутри.
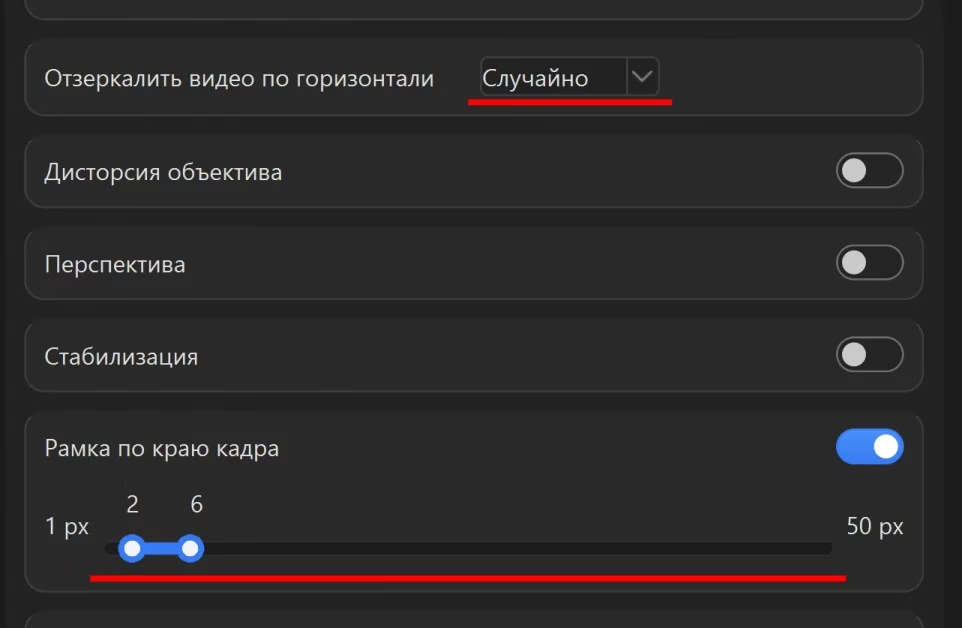
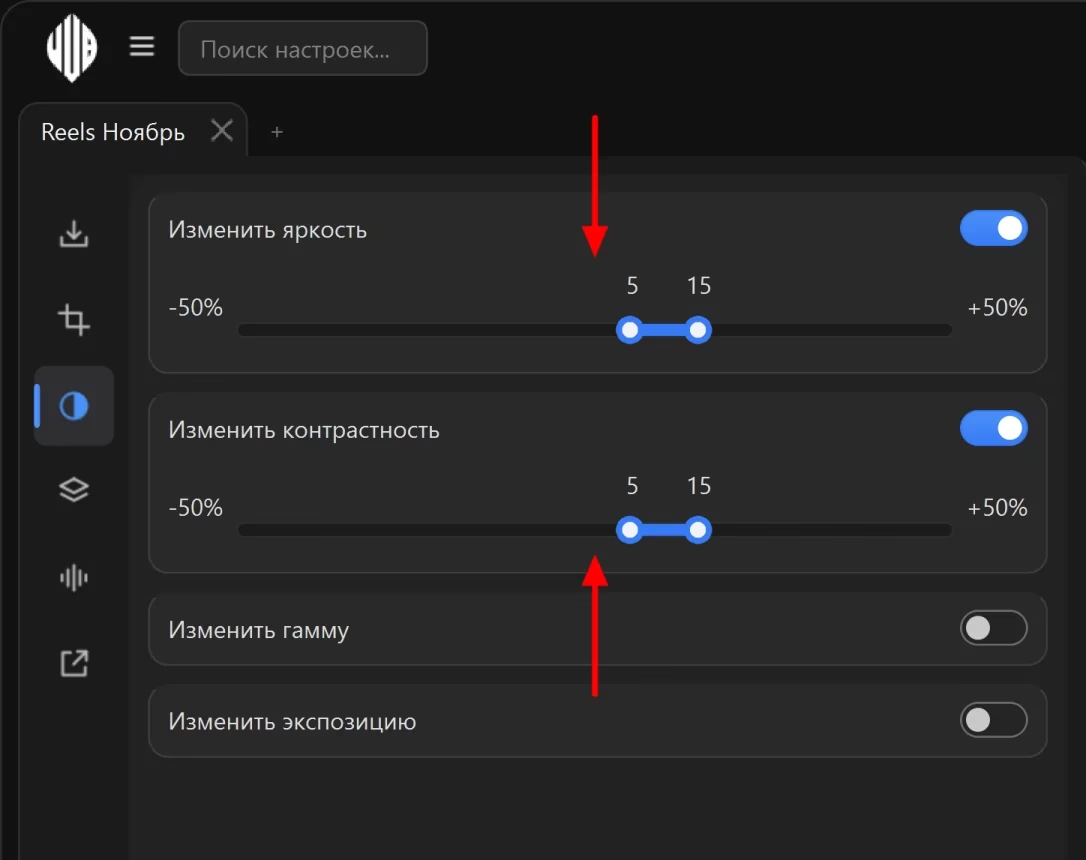
Сверху добавьте диапазоны помельче: обрезка 10-25 px, яркость и контрастность 5-15%, поворот 1-2 градуса и длительность 3-8%. Настройка называется «Изменить длительность видео», и знак у неё читается прямо: плюс делает ролик длиннее и медленнее, минус - короче и быстрее. По временной оси она работает, по звуку почти нет. А обученному детектору копий она даётся легче всего, поэтому одна ничего не решает. Каждое из этих значений задаётся диапазоном, а не одним числом: внутри него программа берёт своё на каждую копию.
Шаг 4. Сделайте три копии и посмотрите их глазами
Этот шаг пропускать нельзя. Диапазон, выставленный наугад, даёт на краях испорченные копии. Без пробного запуска вы узнаете об этом уже после залива.
Поэтому в поле из шага 2 временно поставьте 3 и запустите. Посмотрели - верните своё число и запустите начисто.
Только помните, чего эти три копии не показывают. Значение каждой настройки берётся жребием внутри диапазона, и жребий свой на каждую копию. Поэтому в трёх копиях края почти наверняка не выпадут - а портит кадр именно край. Чтобы увидеть его, сузьте диапазон до верхней границы, сделайте ещё копию и верните диапазон обратно.

Шаг 5. Запускайте полную обработку
Пересвета и заметной порчи на трёх копиях нет - значит, диапазоны подобраны. Дальше считает программа: шесть роликов по сто копий дают шестьсот файлов за один запуск.
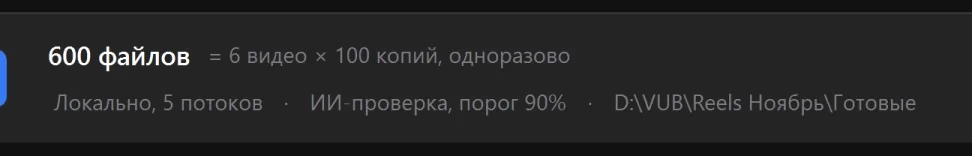
Нажмите кнопку «Запуск» - она стоит слева от этой сводки, на той же полосе.
Дальше окно показывает ход работы: кольцо с долей сделанного и номер файла, который программа делает сейчас.
Как убедиться, что копии действительно разные
Ни одна из разобранных страниц не меряет непохожесть копий: лучшая из них сверяет только метаданные. Своего замера расстояний по копиям мы тоже не делали - числа в таблице операций взяты из двух чужих работ, 1 и 2. Зато есть проверка, которую можно сделать своими глазами за минуту.
Проверка первая, и она почти ничего не значит. Контрольные суммы копий и оригинала различаются всегда - это первый уровень проверки сходства, и его проходит любая операция. Считать дело сделанным нельзя. Мы называем её только потому, что в нише на ней и останавливаются.
Проверка вторая, по делу. Посмотрите на копии подряд, уменьшив их до размера ногтя на экране. Перцептивный отпечаток считается примерно по такой же грубой сетке. Что различимо в этом размере, различит и алгоритм.
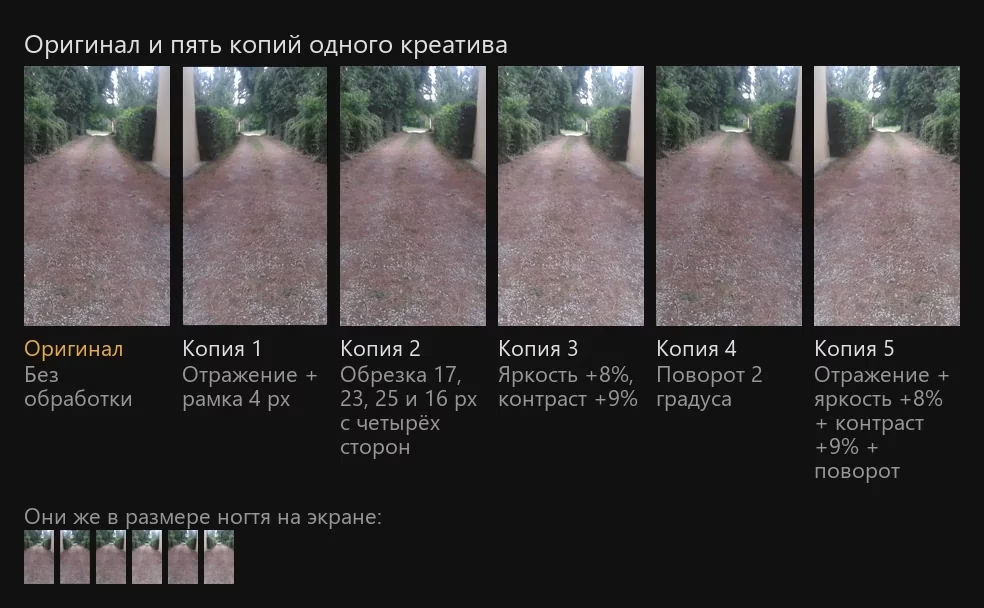
Копии для этого кадра сделаны теми же операциями, какими их делает программа, и в тех же диапазонах, которые советует шаг 3. Поворот идёт с увеличением кадра и обратной обрезкой, поэтому чёрных углов по краям нет. Рамка закрашивает край внутри кадра. Обрезка берёт своё число на каждую из четырёх сторон и возвращает кадр в прежний размер, отчего картинка чуть съезжает и чуть приближается.
Рамку 4 px не различить ни в одном из двух рядов: это 4 px из 720 по ширине кадра, а на картинке выше от неё остаётся один столбец пикселей из 146. И это честная цена приёма: глазу он не мешает. А вот отражение в нижнем ряду видно первым делом: светлый столб у оригинала стоит справа, у зеркальных копий - слева. Так будет не всегда, и в этом вся соль: заметность отражения зависит от того, что в кадре. Если в нём есть приметная несимметричная деталь - столб, логотип, подпись в углу, - зритель поймает зеркало сразу. Симметричный кадр отражение переживает незаметно.
Вторым в том же ряду ловится ровное осветление: две копии, набранные яркостью и контрастом, читаются светлее прочих даже в размере ногтя. Запомните эти два различия, они пригодятся через абзац: первое видно и двигает отпечаток далеко, второе видно не хуже, а отпечаток двигает мало - в тех долях, которыми эти копии набраны.
У этой проверки есть две известные осечки, и без поправки на них она врёт в обе стороны. Зеркальная копия бросается в глаза сильнее прочих, если в кадре есть несимметричная примета, - и по ней легко решить, что операция слишком груба, тогда как отпечаток она двигает сильнее всех остальных. Насыщенность обманывает в другую сторону: глазом видна сразу, а отпечаток двигает на 1-2%.
Отсюда правило чтения, и оно про то, чем набрана разница, а не про её величину. Смотрите не «отличается или нет», а какие операции в копии работают. Есть отражение, рамка или заметная обрезка - отпечаток копии сдвинут далеко, даже если глазом она почти та же. Разница набрана одним цветом или яркостью в тех долях, что стоят в диапазонах выше, - отпечаток почти на месте, и одного этого мало, сколько бы разницы ни было видно. Величина тут всё же решает, просто не там, где её ищут: двукратное усиление контраста двигает отпечаток на 37% битов, сильнее зеркала, но кадр от такого уже испорчен и в ленту не годится.
Проверка третья, на границу порчи. Сделайте копию на верхней границе диапазона - в обычной тройке её не будет, значения там случайные. Посмотрите её глазами зрителя. Видите пересвет, дрожание краёв после поворота или обрезанную подпись? Диапазон надо сузить.
Настроил один раз, повторил на следующем креативе
Про повторяемость не пишет ни одна из разобранных страниц выдачи и ни одна научная работа. А именно она и экономит основное время. Подобранный набор диапазонов программа сохраняет, и следующий креатив берёт его без повторной настройки.
Смысл вот в чём. Диапазоны разумно подбирать под вертикаль и под площадку, а не под конкретный ролик - это наша оценка по риску испортить кадр, замеров по вертикалям нет ни у кого. Для гемблинга с яркими кадрами пределы одни. Для нутры со спокойной съёмкой - другие.
Держите два-три набора под свои вертикали. Тогда подготовка нового креатива займёт столько, сколько идёт обработка.
Где это не сработает
Ролики с крупным текстом в кадре. Отражение переворачивает текст, обрезка режет его по краю. Без этих двух операций набор становится заметно слабее. Для таких креативов остаются скорость, поля и наложения.
Длинные видео. Время обработки растёт вместе с длиной у любого ролика, но у длинных это становится преградой: сотня копий получасового ролика считается часами. А проверка сходства всё равно ищет совпадение по всей длине, а не только в начале.
Чужой контент. Компиляции из чужих коротких роликов уникализация законными не делает. Content ID ловит отражение и скорость, об этом сказано выше.
Одинаковые тексты и посадочные. У тридцати объявлений один заголовок и одна посадочная? Разница в кадрах помогает мало. Креатив - это часть связки, а не вся связка.
Мы видели это не в рекламе, а в сетке аккаунтов X (Twitter), где на пике их было 150 000. Площадка блокировала все аккаунты, у которых в поле ссылки стоял один и тот же домен.
Вопросы и ответы
С чего начать
Возьмите один ролик, который у вас уже отработал. Сделайте три копии с отражением и рамкой плюс диапазонами помельче из таблицы операций. Посмотрите их в миниатюрах рядом с оригиналом - но судите не по тому, видна ли разница, а по тому, чем она набрана: есть ли в наборе сильные операции и не испорчен ли кадр на краях диапазонов. Это и есть готовый набор для всей папки.
Хотите проверить это на своей папке, а не на чужом сервере? Скачайте Video Unique Booster и обработайте тот самый ролик в три копии. Кредиты тратит только облачный режим, локальная обработка идёт без них; сколько видео доступно на тестовом ключе, показывает панель баланса в программе.
Те же приёмы под конкретные площадки разобраны отдельно. Про TikTok - в материале уникализация видео для TikTok. Про YouTube - в материале как уникализировать видео для YouTube. Веб-сервисы - в статье уникализатор видео онлайн.
Источники
Цифры в квадратных скобках по тексту отсылают сюда: так помечены числа из чужих работ и отчётов. Пределы и цены сервисов взяты в сентябре 2026 года со страниц самих сервисов и из разборов ниши; они меняются без предупреждения, а часть страниц к моменту проверки уже не открывалась.
- McKeown S., Buchanan W. J. Hamming distributions of popular perceptual hashing techniques. Forensic Science International: Digital Investigation, 2023, т. 44, 301509. Препринт на arXiv, журнальная версия. ↩︎
- Struppek L., Hintersdorf D., Neider D., Kersting K. Learning to Break Deep Perceptual Hashing: The Use Case NeuralHash. ACM FAccT, 2022. Препринт на arXiv. ↩︎
- Pizzi E. и соавт. The 2023 video similarity dataset and challenge. Computer Vision and Image Understanding, 2024, т. 243, 103997. Препринт на arXiv, журнальная версия. ↩︎
- Wang A. L.-C. An Industrial-Strength Audio Search Algorithm. ISMIR, 2003. PDF доклада. ↩︎
- Six J., Leman M. Panako: A Scalable Acoustic Fingerprinting System Handling Time-Scale and Pitch Modification. ISMIR, 2014. Запись на Zenodo. ↩︎
- Meta ThreatExchange. The TMK+PDQF Video-Hashing Algorithm and the PDQ Image-Hashing Algorithm, технический отчёт. PDF отчёта на GitHub. ↩︎
- Текущие правила YouTube об авторском праве - оттуда число претензий Content ID за 2024 год и доля оспоренных. Отдельно - Google, How Google Fights Piracy, 2018: в отчёте того года доля оспоренных та же, а числа за 2024 год, разумеется, нет. ↩︎