Один ролик опубликован на нескольких аккаунтах. На первом его смотрят, на остальных — намного меньше. Человек на форуме написал в 2023 году: «Видео которое выкладываю первым набирает в разы больше просмотров, наверно инста видит что это перезалив даже с укорачиванием видео» 9.
Речь здесь о сетке аккаунтов в Инстаграм, то есть о нескольких профилях под одно видео. Раскладка ленты профиля плиткой 3×3 — другая тема.
Короткий ответ. Число копий само по себе ничего не решает. С 2024 года из одинаковых роликов Instagram рекомендует только оригинал 1. Поэтому считать надо, насколько копии отличаются друг от друга, причём каждая с каждой. Готового числа копий, подкреплённого методикой, мы не нашли. Искали 23 сентября 2026 года: десять страниц из выдачи в США, научные работы и пять роликов. 27 сентября к ним добавились пять страниц русской выдачи.
Мы — команда Video Unique Booster, делаем программу для уникализации видео. Мы сделали 480 копий трёх роликов и измерили, насколько они похожи друг на друга. Мерой служил перцептивный хеш pHash, один из открытых алгоритмов сверки. Чем больше бит из 64 расходится, тем сильнее отличаются копии. Из двадцати копий с разными правками можно оставить от 13 до 16 так, чтобы любые две расходились хотя бы на два бита. Наборы, собранные кодом самой программы, дали от 15 до 18. Если менять только яркость, контраст и шум, двадцать копий по этой мерке — это один и тот же ролик. Какой порог у Instagram и как биты сказываются на охвате, замер не показывает. В нашей сетке на 300 аккаунтов из одного ролика, по памяти, выходило больше 100 копий, и массового падения просмотров не было. Но это наблюдение, а не замер.
Вот что из этого следует на практике. Копий ролика нужно вдвое больше, чем аккаунтов для него. Потом проверьте их парами скриптом из этой статьи: он уберёт копии из самых близких пар. Сетке на 10 аккаунтов такого запаса хватило у всех наших роликов. Сетке на 50 хватило не у всех, подробности в разделе «Набор для сетки на 50 аккаунтов». Нужны правки разных видов: цвет, геометрия кадра, время и звук. Звук меняют вместе с картинкой. Зеркало — не главная правка.
Копии — только часть сетки. Ещё нужны аккаунты, прокси, прогрев и публикация по расписанию. Ниже — правила площадки, наша сетка на 300 аккаунтов, замер и сборка набора.
Кому это нужно
Тем, кто ведёт пять, двадцать или сотню аккаунтов и публикует на них один и тот же ролик. Так публикуют Reels массово, продают товары и продвигают свой продукт с нескольких профилей. Замер ниже сделан для сеток на 10 и на 50 аккаунтов. Для сетки крупнее порядок действий тот же, а итог покажет скрипт. Общий обзор приёмов уникализации — в статье про уникализатор видео для Инстаграм.
Мы сами вели такую сетку в Instagram с марта по август 2025 года. В ней было около 300 аккаунтов, и публиковались на них только Reels. Один ролик публиковали на многих аккаунтах, и каждый аккаунт получал свою копию из Video Unique Booster.
Уникализатор видео для Windows: сотни копий за запускВручную Вы правите копию за копией. Программа создаёт их пачкой. У каждой свои картинка, звук, метаданные и длительность.
Уникализатор видео Video Unique Booster для WindowsВы кладёте видео и задаёте диапазоны настроек. Программа создаёт сотни копий. У каждой свои картинка, звук и длительность.
Уникализатор видео: сотни копий из одного оригиналаРучной способ упирается в одно. Каждую копию надо править отдельно. Больше копий — больше времени.
Уникализатор видео для TikTok, YouTube и InstagramДиапазоны настроек Вы задаёте один раз. Дальше программа для Windows создаёт копии пачкой. Сотнями за запуск.
Уникализатор видео для Windows — Video Unique BoosterВы добавляете одно видео. Программа создаёт сотни копий. У каждой свои картинка, звук, метаданные и длительность.
Что сказано в правилах Instagram
Правил два. Первое — про одинаковые ролики. Instagram объявил его в апреле 2024 года, как пишет TechCrunch. Если площадка находит два одинаковых ролика и больше, она рекомендует только оригинал 1. Копия при этом не удаляется. Она пропадает из мест, где площадка сама подбирает ролики: Reels, «Интересное», рекомендации в ленте. Существенно изменённый ролик, например мем или пародию, Instagram оригиналом не заменяет 1. Подписчикам аккаунта, который опубликовал копию, Instagram обещал показывать пометку со ссылкой на автора оригинала 1.
У нового аккаунта подписчиков почти нет. Если его копия не попадёт в рекомендации, увидеть её почти некому. Охваты мы не мерили, это вывод из правила.
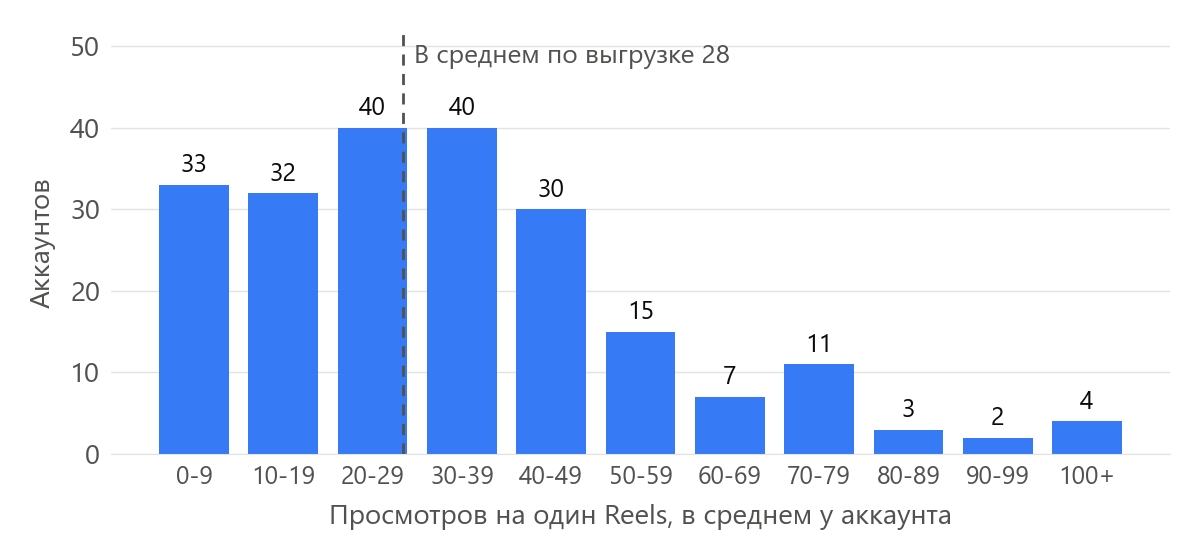
Как мало у таких аккаунтов подписчиков, видно по нашей сетке. В выгрузке по 217 её аккаунтам на всех приходился 141 подписчик, а 6690 Reels набрали 190 134 просмотра. Эти просмотры пришли из рекомендаций, а не от подписчиков.
Второе правило — про аккаунт целиком. Аккаунт, который публикует в основном чужое без существенной переработки, исключается из рекомендаций 23. Вернуться можно, когда за 30 дней большая часть свежих публикаций признана оригинальной 2. Существенная правка чужого ролика, «material edits», может считаться оригинальной 2. А рамку, водяной знак и смену скорости правила прямо называют поверхностными правками, «low-effort edits» 2. В 2024 году, в пересказе Digital Music News, порог назывался числом: больше 10 публикаций чужого контента за 30 дней 4. В объявлении Instagram от 30 апреля 2026 года числа нет — есть слово «primarily», то есть «в основном» 3.
На страницах выдачи о нескольких аккаунтах часто встречается число пять. К сетке оно не относится. Столько аккаунтов приложение Instagram позволяет добавить и переключать без повторного входа 15. Это удобство одного телефона, а не предел сетки.
На открытых нами страницах правил нет двух вещей. Нет числа копий одного ролика. Нет способа, которым площадка находит одинаковые ролики. Правила говорят «одинаковый» и «существенная правка», но порога не называют.
Как мы запускали сетку аккаунтов в Instagram
Кроме копий, сетке нужны аккаунты, прокси, прогрев и публикация. Ниже — наша сетка с марта по август 2025 года. Это опыт одной сетки, а не правило площадки. Точные числа взяты из журнала тестов и из выгрузки программы управления. Остальные — по памяти.
Аккаунты и оформление
Аккаунты мы покупали готовыми. Первый поставщик не подошёл. Instagram блокировал его аккаунты после любого первого действия: смены аватара, лайка, первого ролика. У второго поставщика мы брали аккаунты возрастом от трёх месяцев. Смену аватара, описания и пароля при первом входе там пережили пять аккаунтов из пяти.
Лучше всего прошли аккаунты вовсе без описания, аватара и ссылки. Ролики опубликовали десять таких аккаунтов из десяти. Из аккаунтов с описанием и тегами ролики опубликовали два из пяти, остальные получили блокировку. Смена имени пользователя тоже вызывала блокировки: ролики опубликовали шесть аккаунтов из десяти. А ссылку в профиле, поставленную при оформлении, пережил 21 аккаунт из 22.
Управление, устройства и прокси
Антидетект-браузер мы не использовали. Сеткой управляла программа InstAccountsManager 20. Почти у каждого аккаунта в ней записано своё устройство Android. В выгрузке по 217 аккаунтам — 213 разных устройств. Аккаунты работали через мобильные прокси, которые мы настроили у себя. На одном мобильном прокси одновременно работал один аккаунт. Потом прокси менял IP-адрес, и через него начинал работать следующий аккаунт. Так вся сетка работала через 10 мобильных прокси. Как настроить такие прокси у себя, мы описали в статье про мобильные прокси в домашних условиях.
Прогрев
Аккаунты прогревала та же программа, вручную мы их не трогали. Сначала аккаунт публиковал ролики для охвата, потом ролики с призывом перейти по ссылке. Срок первого этапа мы проверили по дням. Если ролики для охвата шли один день, после роликов со ссылкой Instagram заблокировал половину аккаунтов. После двух, трёх и четырёх дней блокировок тоже было много. После пяти дней ролики со ссылкой без проблем опубликовали 26 аккаунтов из 30. С тех пор порядок был такой: оформление, пять дней роликов для охвата, потом ролики со ссылкой. По памяти, весь прогрев шёл неделю или дольше.
Публикация
Каждый аккаунт публиковал три ролика в сутки: в 7, 12 и 18 часов. Публиковала их программа управления сеткой, без ручной загрузки. Она брала ролики из папки, куда Video Unique Booster сохранял готовые копии. Ролики были чужие: мы брали их с YouTube-каналов и из Telegram-каналов нашей тематики. Мы уникализировали сразу около 50 роликов. Их копии публиковались в сетке вперемешку, а не все копии одного ролика разом. Из одного ролика за всё время выходило больше 100 копий.
Новый ролик мы сначала публиковали на части сетки, на 30-50 аккаунтах. За ним следили день-два. Если просмотры шли, а переходов не было, ролик убирали.
Главный аккаунт и итог
Ролики вели на один главный аккаунт внутри Instagram. Он был закрыт. Чтобы он не выглядел пустым, мы сделали в нём около 50 публикаций. Ссылка на Telegram-канал стояла только у него. Этот аккаунт ни разу не блокировали.
Просмотров на ролик было немного. В выгрузке 190 134 просмотра на 6690 Reels, в среднем около 28. Выгрузка неполная: в неё попали не все аккаунты. Отдельные ролики, по памяти, набирали по 10-15 тысяч просмотров. Но цель сетки была не в просмотрах, а в переходах. Ролики с просмотрами и без переходов мы убирали. Сетка окупалась. За месяц, описанный в нашем кейсе, она принесла 4 046 долларов дохода, из них 3 750 долларов чистыми.
Проверки площадки
По памяти, около 60% аккаунтов с роликами попадали на проверки площадки. В выгрузке, где остались только рабочие аккаунты, доля меньше. Хотя бы одну проверку там получили 84 аккаунта из 217, это 39%. Чаще всего Instagram просил подтвердить, что действия не автоматические. Таких проверок в выгрузке 1342. Проверок «Я не робот» — 195. Проверок по номеру телефона — 23. Аккаунты приходилось восстанавливать и параллельно прогревать новые на замену. Проверку «Я не робот» проходили через сервис решения капчи: в журнале тестов это сработало три раза из трёх. Для проверки по телефону брали сервис, где на один номер приходит много сообщений. Так на один номер мы восстанавливали около десяти аккаунтов.
С аккаунтов, где ролики перестали набирать просмотры, мы снимали ссылку и откладывали их на месяц. Около 20% из них потом снова набирали просмотры.
Подробнее эту сетку со снимками экрана мы разбирали в рекомендациях по использованию уникализированных видео.
Почему считать надо пары копий
Правило говорит о любых двух одинаковых роликах на площадке 1. Значит, речь о каждой паре роликов на площадке, в том числе о парах копий между собой. У сетки из десяти аккаунтов десять копий. Это 45 пар. Если сверять каждую копию только с исходным роликом, пар 10. Если опубликован и сам исходный ролик, пар 55. У двадцати копий пар уже 190. Если площадка сочтёт одинаковыми копии хотя бы одной пары, хотя бы одна из двух не попадёт в рекомендации.
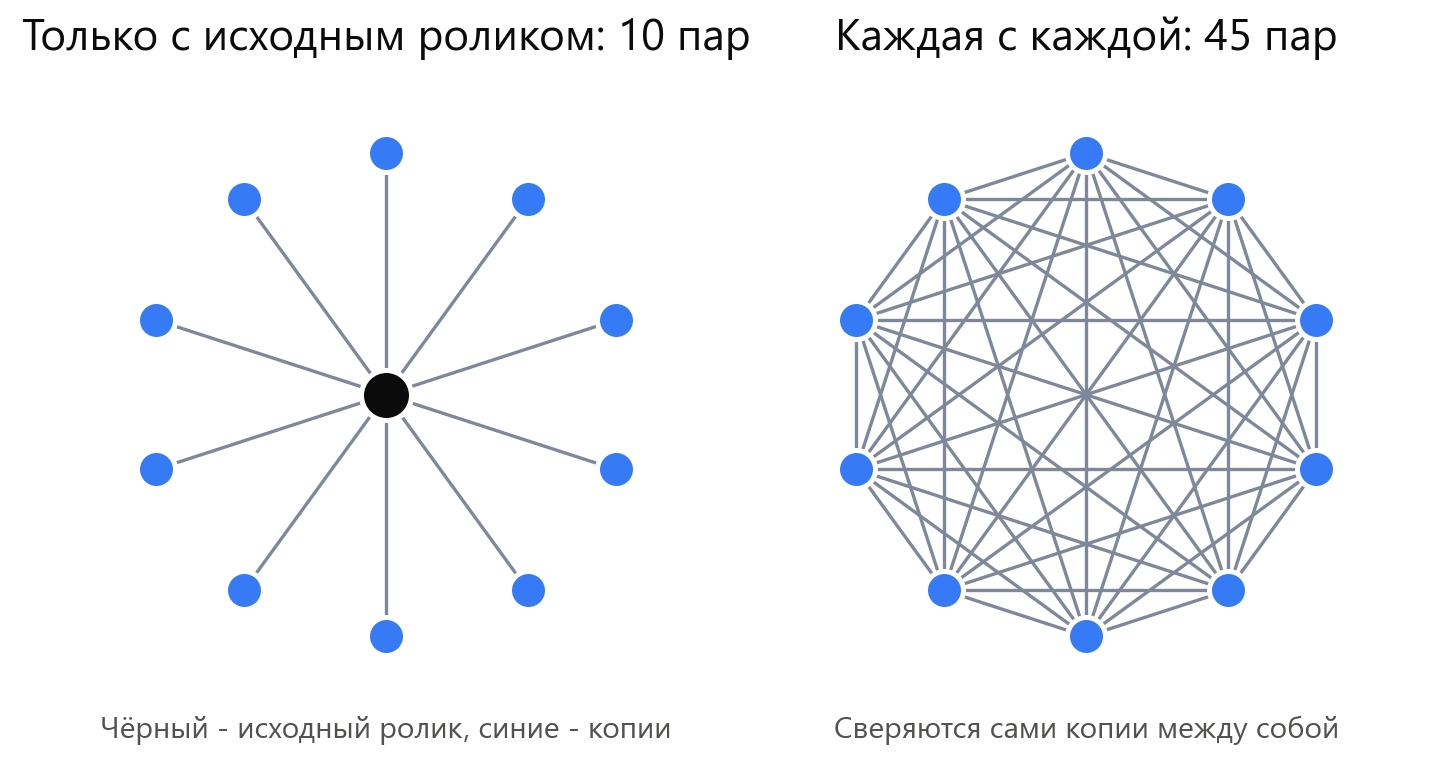
Поэтому мы измерили расстояние между копиями одного набора.
Как мы мерили
Замер мы сделали 23 сентября 2026 года. Взяли три ролика из открытого набора видео VISION 16. Их сняли на телефоны Samsung Galaxy S3 Mini, Apple iPhone 6 и Huawei P9. Это панорамы с поворотом камеры: два ролика в помещении, один на улице. От каждого — первые 12 секунд. На обычный ролик для Reels они не похожи: в кадре нет людей и товара, а надписи только на заднем плане. Поэтому числа ниже — ориентир. Свой набор проверьте скриптом из этой статьи. Из каждого ролика — два набора по 20 копий. Наборы собирал наш скрипт, а не Video Unique Booster. Всего 120 копий и 1140 пар: по 570 в узких и в широких наборах. Ещё 60 копий 24 сентября собрал код самой программы, о них — в разделе про её настройки.
«Узкий» набор — так выглядит уникализация одним-двумя приёмами. Каждая копия получает случайную яркость в пределах 3%, случайный контраст и слабый шум. Метаданные стёрты. Геометрия и звук не тронуты.
«Широкий» набор — так работают программы с диапазоном значений у каждой правки. Каждая копия получает своё случайное сочетание правок:
- Зеркало: с вероятностью 50%.
- Обрезка краёв: от 2 до 10%.
- Скорость: от 0,95 до 1,08.
- Высота тона: от 0,97 до 1,04.
- Рамка, цвет и шум.
Картинку сравнивали перцептивным хешем pHash 5. Это короткий отпечаток кадра: похожие кадры дают похожие отпечатки. Отпечаток занимает 64 бита. На копию мы брали 16 кадров. Расстояние между копиями — среднее по 16 кадрам. Поэтому оно бывает дробным. Ноль означает, что хеши кадров совпадают. Около 31 бита — так расходятся два несвязанных изображения 5. Кадры брали в одних и тех же долях длины ролика. Так ускоренная копия сравнивается по тому же моменту съёмки.
Звук сравнивали отпечатком по принципу Шазама 7. Из спектрограммы берутся пары пиков: две частоты и шаг по времени между ними. Каждая такая пара — метка. Мы считали долю общих меток у двух копий, без выравнивания по времени. У копий разных роликов эта доля — от 1,1 до 8,3%, медиана 3,6%. Мера грубая. У одного ролика даже пересжатие без правок оставило 56% общих меток. У двух других — 89 и 96%.
Отдельно мы посчитали расстояние с поправкой на зеркало. Открытый алгоритм Meta PDQ считает хеши всех восьми поворотов и отражений кадра почти без дополнительных вычислений 6. Для такой сверки зеркальная копия — это не новая картинка. Какой механизм стоит за правилом Instagram, на открытых нами страницах площадки не сказано. Мы показываем оба числа.
Насколько похожи копии
Расстояние — в битах из 64, медиана по всем парам трёх роликов. Для сравнения: три ролика отличаются от своего пересжатия без правок на 0 бит, 0,25 и 0,38 бита.
| Узкий набор | Широкий набор | |
|---|---|---|
| Пар копий | 570 | 570 |
| Картинка с поправкой на зеркало, медиана | 0,38 | 6,38 |
| Самая близкая пара с поправкой на зеркало | 0 | 0,38 |
| Звук, доля общих меток, медиана | 100% | 7% |
Узкий набор. Расстояние между копиями — от 0 до 1,12 бита. Это того же порядка, что и расхождение ролика с его пересжатием. У всех 60 копий разные контрольные суммы файлов: по файлу это двадцать разных роликов на каждый исходный ролик. По картинке это один ролик.
Широкий набор. По простому хешу пары делятся на две группы. Если отражена одна копия из двух, медиана по роликам — от 31,6 до 33 бит. Это почти расстояние между несвязанными изображениями 5. Если зеркало у обеих копий одинаковое, медиана — от 5,3 до 8,1 бита. С поправкой на зеркало медиана всех пар — 6,38 бита.
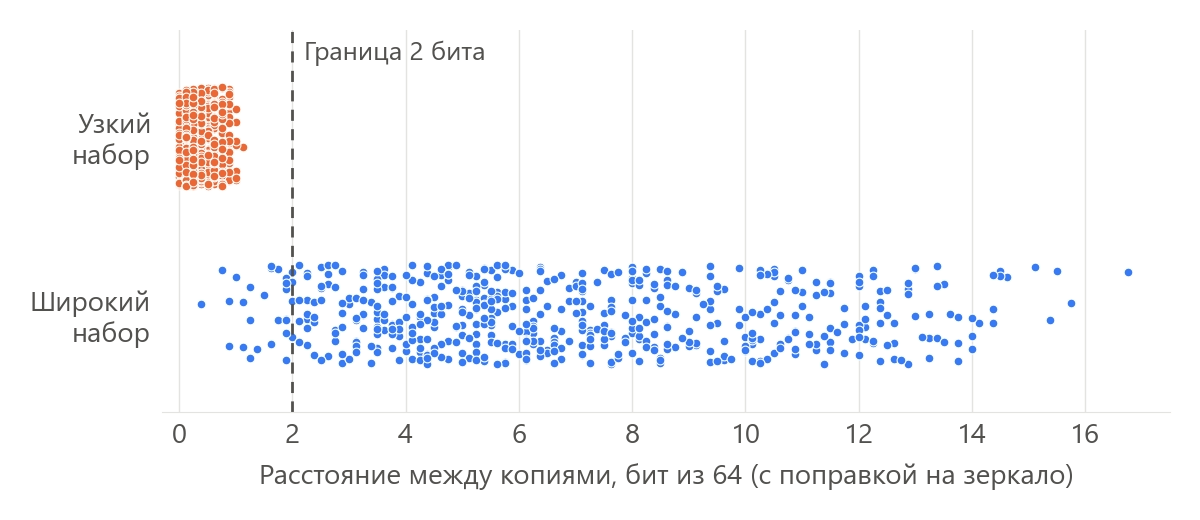
Главное число — расстояние у самой близкой пары. Мы проследили его при росте набора. Расстояние с поправкой на зеркало, в битах:
| Копий в наборе | Samsung | iPhone | Huawei |
|---|---|---|---|
| 5 | 1,25 | 5,12 | 2,00 |
| 10 | 0,88 | 1,25 | 1,88 |
| 20 | 0,88 | 0,75 | 0,38 |
С ростом набора расстояние у самой близкой пары сократилось у всех трёх роликов. Расти это расстояние не может: новые копии только добавляют пары. У двадцати копий каждого ролика нашлась пара ближе одного бита. Самая близкая пара каждого ролика — зеркальные отражения друг друга. По простому хешу их разделяет 30,5-31,9 бита, с поправкой на зеркало — меньше бита. У ролика Huawei есть и вторая такая пара ближе бита: в ней отражены обе копии.
Сколько копий остаются разными
Теперь ответ на вопрос заголовка. Для каждого набора мы нашли наибольшую группу копий, в которой каждая пара не ближе порога. Расстояние — с поправкой на зеркало. Instagram свой порог не публикует, поэтому в таблице несколько порогов. Копий в широком наборе было 20:
| Порог, бит | Samsung | iPhone | Huawei |
|---|---|---|---|
| 1 | 19 | 19 | 18 |
| 2 | 16 | 16 | 13 |
| 3 | 10 | 13 | 9 |
| 4 | 8 | 10 | 6 |
| 6 | 4 | 6 | 4 |
Самые далёкие копии узкого набора расходились на 1,12 бита. Порог в два бита почти вдвое выше. От узкого набора при пороге 1,5 бита остаётся одна копия у каждого ролика. Из широкого набора часть копий тоже придётся убрать как слишком близкие. Поэтому сетке на десять аккаунтов нужен набор больше десяти копий.
Порог площадки неизвестен. У открытого алгоритма Meta порог совпадения выбирает тот, кто строит систему. По словам Meta, при хеше в 256 бит хорошие результаты дают пороги 30, 20 бит и меньше 6. У pHash другая длина хеша и другая шкала, поэтому переносить эти числа на наш замер нельзя. Как биты связаны с охватом в Instagram, замер тоже не показывает.
Звук и зеркало
Нетронутый звук совпадает целиком
Совет из ролика про уникализацию: «звук можно не трогать» 10. Довод там такой: соцсети сами разрешают использовать чужой звук. Но если звук не трогать, его отпечаток у всех копий один. Это ожидаемо, и замер это подтвердил. В узком наборе звук не трогали, и доля общих меток у всех 570 пар — 100%. По звуку двадцать копий — один ролик. Сверяет ли Instagram звук, когда ищет одинаковые ролики, неизвестно.
В широком наборе менялись тон и темп, и медиана доли общих меток упала до 7%. По роликам — 10%, 2% и 6%. У копий разных роликов доля общих меток — от 1,1 до 8,3%. Копии по звуку сильно разошлись. Но у ролика с Samsung общих меток у любой пары копий больше, чем у любых двух разных роликов. Тон и темп в замере менялись вместе, по отдельности мы их не мерили.
Зеркало помогает меньше, чем кажется
По простому хешу зеркальная копия выглядит как другое изображение. В работе McKeown и Buchanan зеркало дало среднее расстояние в 0,49 длины хеша pHash, то есть около 31 бита из 64. Проверяли это на 250 000 изображений 5. Столько же дают два несвязанных изображения 5.
Но сверка с разворотом кадра зеркало учитывает: PDQ заранее считает хеши отражений кадра 6. В парах нашего широкого набора, где отражена одна копия из двух, поправка на зеркало убрала около четырёх пятых расстояния.
Как собрать набор копий под сетку аккаунтов
Из замера следуют четыре правила.
Первое. Нужны правки разных видов: цвет, геометрия кадра, время и звук. Копии, где менялись только яркость, контраст и шум, разошлись между собой не больше чем на 1,12 бита. Сжатие JPEG в работе McKeown и Buchanan оставило хеш pHash нетронутым у 83,9% изображений 5. Обрезка и рамка сдвигают хеш сильнее 5. Но и одной обрезки мало. Исследователи копий видео считают ролик дубликатом и после правок яркости, цвета, перекодирования, шума и обрезки 8. Поэтому в рецепте ниже к ним добавлены правки времени и звука.
Второе. Звук меняют вместе с картинкой. Сикс и Леман в работе 2014 года проверяли открытую реализацию схемы Шазама 19. Отпечаток пережил растяжение времени. Сдвиг тона больше 3% и одновременную смену тона и темпа он не пережил. Собственная система авторов, Panako, держит правки тона и темпа до десяти процентов. Подробнее мы разбирали это в статье про уникализатор креативов. Наш замер тон и темп не разделял. Кадры он брал в долях длины, поэтому скорость в нём картинку не сдвигает.
Третье. Зеркало не главная правка. Оно работает против простого хеша и не работает против сверки с разворотом. Даже при сверке с разворотом вреда от зеркала нет. Но надписи в кадре после отражения читаются задом наперёд.
Четвёртое. Случайные значения не гарантируют разные копии. У ролика с Huawei две копии получили одинаковые скорость, тон, зеркало и рамку. Звук у них совпал на 100%, картинка разошлась на 1,88 бита. Случай единичный: одна пара из 570. В нашем скрипте значения округлялись до тысячных, и это повышало шанс совпадения. Поэтому копий делают больше, чем аккаунтов, а после создания набор проверяют парами.
Как это устроено в Video Unique Booster
В Video Unique Booster число копий задаётся настройкой «Количество уникальных копий каждого видео». По умолчанию их 10. У каждой копии значение каждой правки берётся заново. Это случайное число из диапазона настройки. Зеркало в режиме «Случайно» включается у каждой копии с вероятностью 50%. Сами случайные значения на близость не проверяются.
Настройка «Проверка сходства» сравнивает новую копию с оригиналом и с каждой ранее созданной копией того же видео. Если сходство хотя бы с одной из них превышает «Порог сходства», программа применяет действие из настроек. Действие «Удалить и создать новое» пересоздаёт копию. Число попыток задаёт настройка «Попыток пересоздать видео», по умолчанию их 10. Сама проверка по умолчанию выключена, а действие по умолчанию — «Удалить».
Мы запустили код этой проверки на всех 1140 парах замера. Способ «Индексирование видео v2» усредняет два сравнения: по цвету кадров и по pHash кадров, взятых раз в секунду. Кадр считается совпавшим, если хеши расходятся не больше чем на 12 бит. Итог округляется вверх до десятков процентов. Вот что вышло при пороге 90%:
- Узкий набор: 564 пары из 570 получили 100%, остальные — 90%. Длительность у этих копий одна, и почти одинаковые копии проверка отсекает.
- Пары, где отражена одна копия из двух, получили не больше 50%.
- В широком наборе 24 пары ближе двух бит. Проверка отсекла одну из них — пару Huawei с одинаковыми скоростью и тоном. Остальные 18 отсечённых пар лежат дальше двух бит, вплоть до 9,5 бита.
- В широком наборе 7 пар не дальше 1,12 бита, как в узком. Проверка не отсекла ни одной, хотя у двух из них зеркало одинаковое.
- Проценты с битами связаны слабо. Пара Huawei на 0,88 бита получила 80%, а пара на 9,5 бита — 100%. Причин две: допуск в 12 бит на кадр и кадры раз в секунду. При разной длительности они приходятся на разные моменты съёмки.
Звук и зеркало проверка не сравнивает. Почти одинаковые копии она ловит, только если у них совпала длительность. А в рецепте ниже длительность меняется у каждой копии. Поэтому для сетки проверку можно не включать: отбор делает скрипт из раздела «Как проверить набор самому».
Настройки для сетки по разделам программы
Числа для правок взяты из статьи про уникализатор креативов и из замера. Стрелка на снимке указывает, что нужно изменить. Цифры на снимке идут в том же порядке, что и настройки в тексте. Где стрелок нет, ничего менять не надо.
Сначала добавьте ролик в «Загруженные видео». Для этого нажмите «Загрузить больше видео» под списком или перетащите файл в список. Можно добавить сразу все ролики для сетки: копии сохранятся в одну папку, а скрипт разберёт их по роликам.
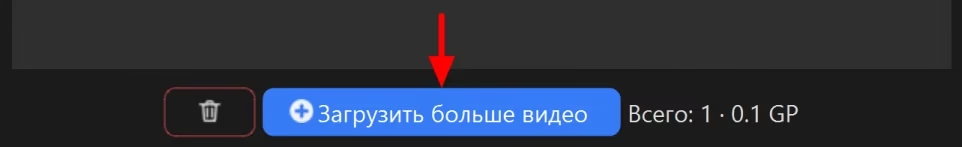
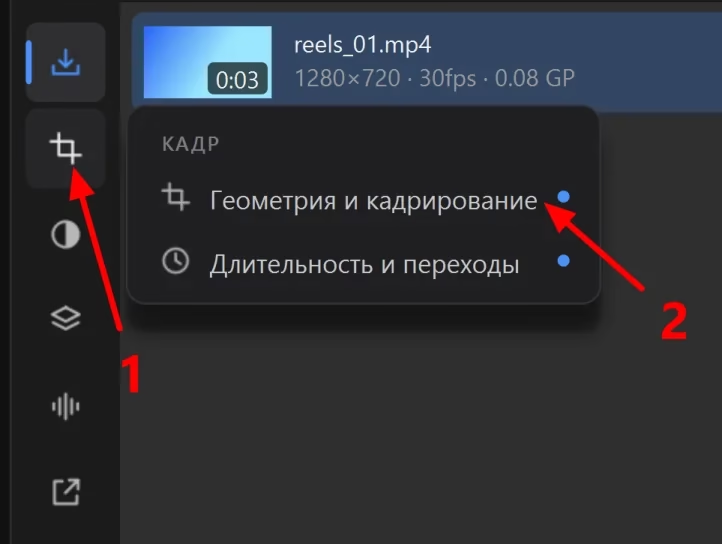
Остальные разделы открываются значками на панели слева. Подписей у значков нет. Наведите курсор на значок: справа выедет карточка со списком разделов. Нажмите нужный раздел. Значков шесть, карточки у них сверху вниз такие: «МАТЕРИАЛ», «КАДР», «СТИЛЬ», «НАЛОЖЕНИЯ», «ЗВУК», «ВЫВОД». «Геометрия и кадрирование» и «Длительность и переходы» лежат в карточке «КАДР». «Свет и тон» и «Фактура и детали» — в карточке «СТИЛЬ». «Звук видео» — в карточке «ЗВУК». «Экспорт» — в карточке «ВЫВОД» у нижнего значка.
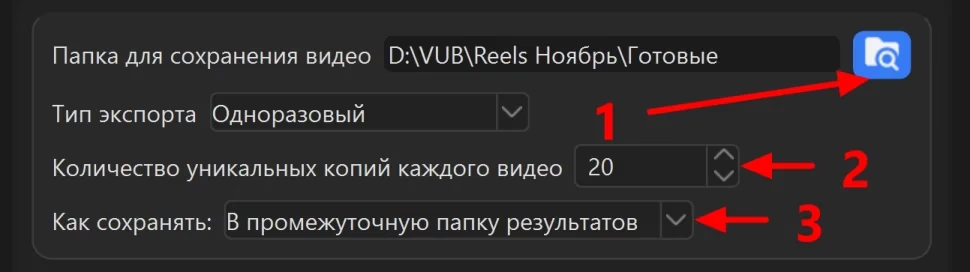
Раздел «Экспорт». Нажмите кнопку с папкой справа от поля «Папка для сохранения видео» и выберите папку для копий. В «Количество уникальных копий каждого видео» поставьте вдвое больше, чем аккаунтов. Для сетки из десяти это 20. В настройке «Как сохранять» выберите «В промежуточную папку результатов». Тогда копии всех роликов сохранятся в одну папку VUB_result_ с датой и временем. Имя копии — имя ролика и номер копии. Папка VUB_result_ появится внутри выбранной. Скрипт читает именно такую папку.
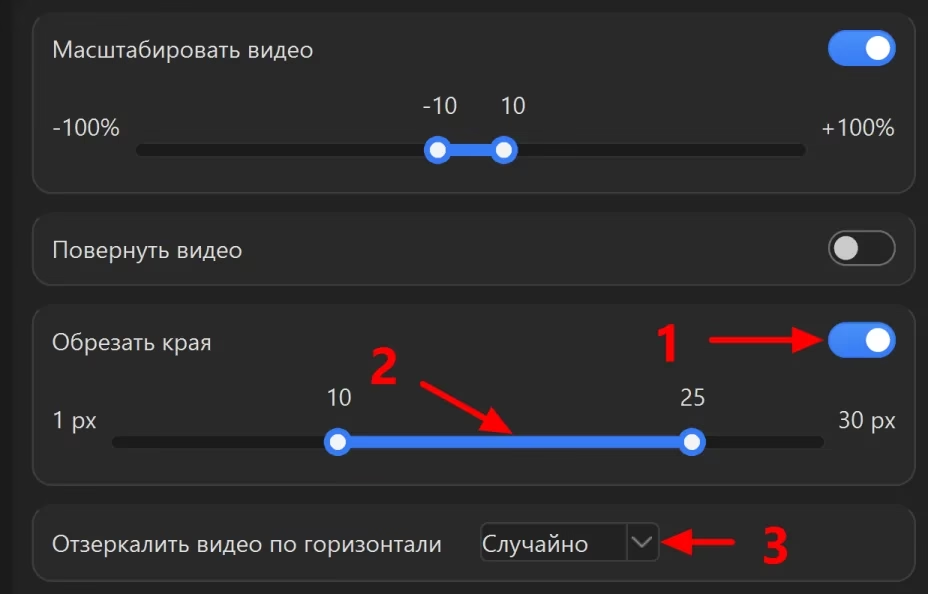
Раздел «Геометрия и кадрирование». Настройка «Масштабировать видео» уже включена, её оставьте как есть. Включите настройку «Обрезать края» и поставьте от 10 до 25 px. Такую обрезку разбирает статья про креативы. Значение по умолчанию, 1-5 px, слабее: замер обрезал края на 19-96 px. В настройке «Отзеркалить видео по горизонтали» выберите «Случайно», если в кадре нет надписей. Если надписи есть, выберите «Нет»: отражённый текст читается задом наперёд. Скрипт сравнивает копии с поправкой на зеркало.
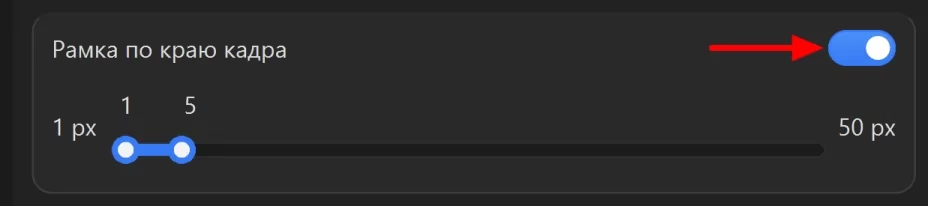
Ниже в том же разделе включите настройку «Рамка по краю кадра», ползунок оставьте. Та статья показывает рамку на 2-6 px, но нашего замера под этим числом нет.
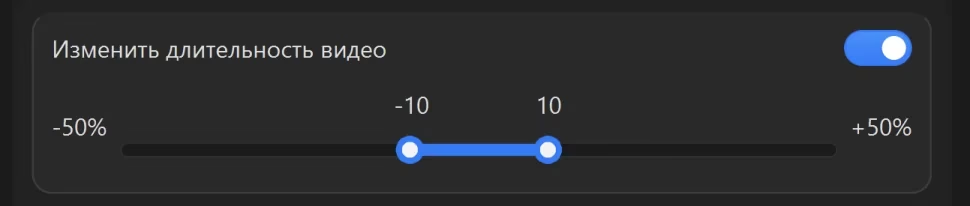
Раздел «Длительность и переходы» лежит в той же карточке, что и геометрия. Настройка «Изменить длительность видео» уже включена, от -10 до +10%. Оставьте как есть. Картинку она растягивает вместе со звуком, а высоту голоса сама не меняет. Вместе с настройкой «Изменить тон аудио» у копии меняются и тон, и темп.
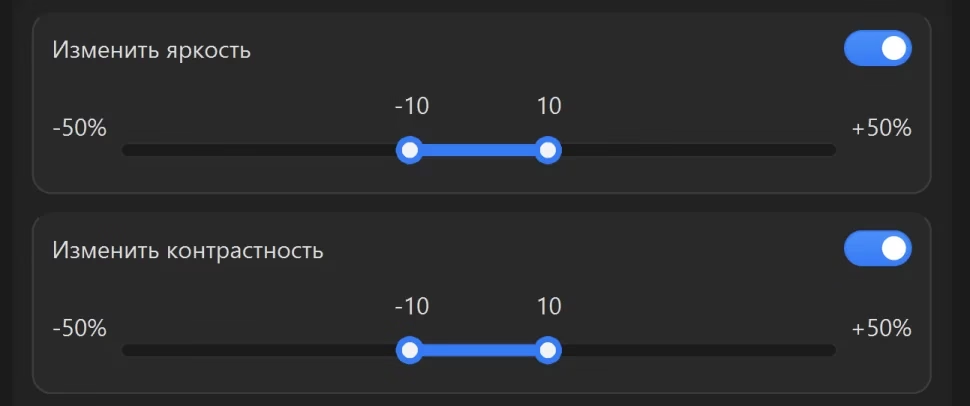
Раздел «Свет и тон». Настройки «Изменить яркость» и «Изменить контрастность» уже включены, от -10 до +10%. Оставьте как есть. В статье про креативы ползунок стоит на 5-15%, но это разброс в 10 пунктов вместо 20. Чем уже разброс, тем ближе друг к другу копии.
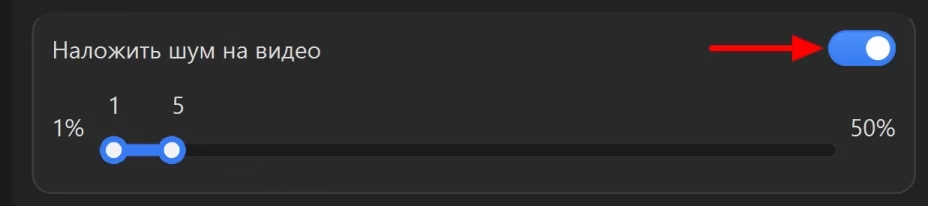
Раздел «Фактура и детали». Включите настройку «Наложить шум на видео». Для шума готовых чисел у нас нет, ползунок оставьте.
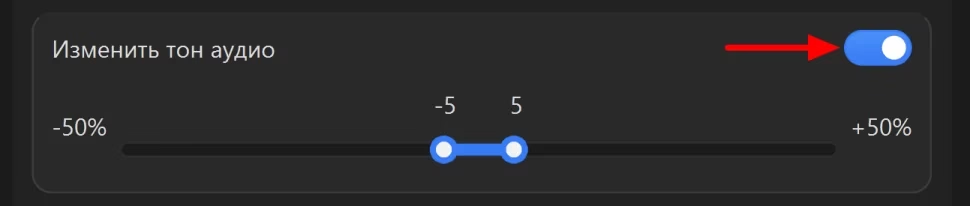
Раздел «Звук видео». Включите настройку «Изменить тон аудио», диапазон от -5 до +5% оставьте. В работе 19 сдвиг тона больше 3% сбивал открытую реализацию схемы Шазама, а система самих авторов держала до 10%. Но значение берётся случайно. Примерно трём копиям из пяти достанется сдвиг меньше 3%. Звук скрипт не проверяет.
Настройки программы совпадают с правками замера не во всём. Рамку программа рисует внутри кадра, толщиной 1-5 px. Замер добавлял её снаружи, 12-36 px, и рамку получили 46 копий из 60. Программа срезает каждый край на своё число пикселей, от 10 до 25, и растягивает кадр обратно. Замер срезал противоположные края поровну. Шум в программе — от 1 до 5, в замере был от 0 до 8. Ещё в программе есть «Масштабировать видео», по умолчанию ±10%, а в замере такой правки не было.
По умолчанию включены ещё «Изменить резкость» и «Изменить громкость». Их можно оставить: в наборе программы ниже они были включены во всех 60 копиях. Цветокоррекция в новом проекте выключена. Пока в разделе «Цветокоррекция» не включена настройка «Использовать цветокоррекцию», на цвет копий влияют только яркость и контраст.
Когда настройки готовы, нажмите «Запуск» внизу окна. Откроется окно «Проверка перед запуском». Нажмите в нём «Запустить». Если окно предупреждает о дневном лимите, копий выйдет меньше заданного. Тогда проверьте их число в папке.
24 сентября мы собрали наборы и кодом самой программы, ровно по этим настройкам. Цветокоррекцию не включали, с ней набор мы не мерили. Видео создавал тот же код, который работает в Video Unique Booster. Ролики те же три, по 20 копий из каждого: всего 60 копий и 570 пар. Мерки те же. Расстояния — с поправкой на зеркало, в битах:
| Набор программы | Samsung | iPhone | Huawei |
|---|---|---|---|
| Медиана расстояния между копиями | 6,62 | 8,12 | 5,44 |
| Самая близкая пара | 1,75 | 1,75 | 1,0 |
| Копий попарно не ближе 2 бит | 18 из 20 | 18 из 20 | 15 из 20 |
| Копий попарно не ближе 4 бит | 8 из 20 | 8 из 20 | 7 из 20 |
| Звук, медиана доли общих меток | 10% | 2% | 6% |
При пороге в два бита у набора программы осталось 18, 18 и 15 копий, у широкого набора нашего скрипта — 16, 16 и 13. При четырёх битах — 8, 8 и 7 против 8, 10 и 6. На каждый ролик собрано по одному набору, и при другом случайном выборе значений числа могли выйти иными. Программа делает такие копии сразу для всей папки роликов и без командной строки.
Пары ближе двух бит есть и здесь. У Huawei самая близкая пара — зеркальные отражения друг друга. Мы запустили на этих наборах код «Проверки сходства»: способ «Индексирование видео v2», порог по умолчанию 90%, действие «Удалить». Она убрала бы 2, 1 и 5 копий. У оставшихся самая близкая пара — 1,75; 1,75 и 1,25 бита. Поэтому набор, собранный программой, тоже проверьте скриптом из раздела «Как проверить набор самому».
Набор для сетки на 50 аккаунтов
26 сентября мы собрали наборы крупнее: по 100 копий из каждого из трёх роликов. Это запас «вдвое» для сетки на 50 аккаунтов. Собирал их тот же код программы, по тем же настройкам. В каждом наборе 4950 пар. Расстояния — с поправкой на зеркало, в битах:
| Набор из 100 копий | Samsung | iPhone | Huawei |
|---|---|---|---|
| Медиана расстояния между копиями | 6,5 | 8,25 | 6,12 |
| Самая близкая пара | 0,75 | 0,62 | 0,75 |
| Копий попарно не ближе 2 бит | 68 | 73 | 54 |
| Копий попарно не ближе 4 бит | 16 | 25 | 10 |
| Самая близкая пара среди 50 копий, оставленных отбором скрипта | 2,25 | 2,5 | 1,88 |
При наилучшем выборе и пороге в два бита запаса «вдвое» хватило всем трём роликам: подходящих копий 54-73 при нужных 50. При четырёх битах не хватило ни одному: подходящих копий 10-25. Отбор скрипта проще наилучшего выбора. У ролика с Huawei он оставил 50 копий с парой на 1,88 бита, хотя 54 копии не ближе двух бит в наборе были. По правилу ниже копии этого ролика ещё не готовы: нужен новый запуск с большим числом копий. Этот отбор мы повторили по расстояниям замера, а не запуском скрипта на файлах.
Как проверить набор самому
Из каждой копии берутся 16 кадров в одних и тех же долях длины. Для каждого кадра и его зеркального отражения считается pHash. Для каждого кадра пары копий берётся меньшее из прямого и зеркального расстояния, затем среднее по 16 кадрам. Пары сортируются. Смотреть надо на самую близкую пару, а не на среднюю.
Вручную это долго, поэтому ниже готовый скрипт. Порядок для Windows:
- Установите Python 12. При установке отметьте пункт добавления Python в PATH.
- Скачайте FFmpeg для Windows. На странице загрузки 13 есть ссылки на готовые сборки, например от gyan.dev 18. Распакуйте архив и возьмите из папки bin файл ffmpeg.exe.
- Создайте папку, например D:\proverka. Положите в неё ffmpeg.exe.
- Сохраните в ту же папку скрипт ниже под именем check_pairs.py.
- Откройте папку в Проводнике. В адресной строке наберите cmd и нажмите Enter. Откроется командная строка.
- Установите библиотеки ImageHash 14 и Pillow 17 одной командой.
pip install ImageHash Pillow
Скрипт:
import itertools, re, subprocess, sys, tempfile
from collections import defaultdict
from pathlib import Path
import imagehash
from PIL import Image, ImageOps

FRAMES = 16
HERE = Path(__file__).resolve().parent
FFMPEG = str(HERE / "ffmpeg.exe") if (HERE / "ffmpeg.exe").exists() else "ffmpeg"

def run(*args):
    return subprocess.run([FFMPEG, *args], capture_output=True, text=True, encoding="utf-8", errors="replace")

def hashes(video):
    h, m, s = re.search(r"Duration: (\d+):(\d+):([\d.]+)", run("-i", str(video)).stderr).groups()
    seconds = int(h) * 3600 + int(m) * 60 + float(s)
    plain, mirrored = [], []
    with tempfile.TemporaryDirectory() as tmp:
        for i in range(1, FRAMES + 1):
            frame = Path(tmp) / f"{i}.png"
            run("-v", "error", "-ss", str(seconds * i / (FRAMES + 1)), "-i", str(video), "-frames:v", "1", "-y", str(frame))
            image = Image.open(frame).convert("RGB")
            plain.append(imagehash.phash(image))
            mirrored.append(imagehash.phash(ImageOps.mirror(image)))
    return plain, mirrored

folder = Path(sys.argv[1])
accounts = int(sys.argv[2]) if len(sys.argv) > 2 else None
# Копия ролика «клип.mp4» называется «клип_7.mp4»: группа - имя без номера копии.
groups = defaultdict(list)
for video in sorted(folder.iterdir()):
    if video.suffix.lower() in (".mp4", ".mov"):
        groups[re.sub(r"_\d+$", "", video.stem)].append(video)

for clip, videos in groups.items():
    print(f"== {clip}: копий {len(videos)}")
    if len(videos) < 2:
        continue
    data = {v.name: hashes(v) for v in videos}
    pairs = []
    for a, b in itertools.combinations(data, 2):
        (pa, ma), (pb, _) = data[a], data[b]
        distance = sum(min(x - y, xm - y) for x, xm, y in zip(pa, ma, pb)) / FRAMES
        pairs.append((distance, a, b))
    pairs.sort()
    for distance, a, b in pairs[:10]:
        print(f"{distance:5.2f}  {a}  {b}")
    if accounts:
        keep = set(data)
        while len(keep) > max(2, accounts):
            distance, a, b = next(p for p in pairs if p[1] in keep and p[2] in keep)
            keep.discard(b)
        closest = next(p for p in pairs if p[1] in keep and p[2] in keep)
        extra = folder.parent / (folder.name + "_лишние")
        extra.mkdir(exist_ok=True)
        for name in sorted(set(data) - keep):
            (folder / name).rename(extra / name)
        print(f"Оставлено копий: {len(keep)}. Самая близкая пара среди них: {closest[0]:.2f} бита")
        print(f"Перенесено в {extra.name}: {len(data) - len(keep)}")
    print()
Запустите скрипт, указав папку с копиями и число аккаунтов. Скрипт делит папку по роликам по имени файла: копия ролика «клип.mp4» называется «клип_7.mp4». Подпапки он не читает. Если в пути есть пробел, возьмите путь в кавычки:
python check_pairs.py "D:\VUB\Reels Ноябрь\Готовые\VUB_result_24092026_153000" 10
Скрипт берёт файлы .mp4 и .mov. Для каждого ролика он печатает десять самых близких пар: расстояние в битах и имена двух файлов. Потом он убирает по одной копии из самой близкой пары, пока у ролика не останется столько копий, сколько аккаунтов, но не меньше двух. Убранные копии он переносит в соседнюю папку с тем же именем и словом «_лишние» на конце. В папке VUB_result_ остаются только отобранные копии, на неё и направляйте программу публикации.
Смотрите на строку «Оставлено копий»: в ней расстояние у самой близкой пары среди оставленных. Если расстояние не меньше двух бит, копии этого ролика прошли нашу границу. Это граница похожести пар, а не охвата: связь битов с просмотрами мы не мерили. Если пара ближе двух бит, запустите программу на этом ролике ещё раз, поставив копий больше, и проверьте новую папку VUB_result_. Сколько добавить, мы не мерили. Но в наборах из 100 копий подходящих при двух битах было больше, чем нужно: 54-73 на 50 аккаунтов.
Два бита — нижняя граница, а не гарантия. Звук скрипт не проверяет. Его числа расходятся с замером до 0,63 бита: скрипт и замер по-разному читают длину ролика. Четыре бита для сетки обычно недостижимы: из 100 копий так далеко друг от друга оставалось 10-25. Если число аккаунтов не указать, скрипт только напечатает пары и ничего не перенесёт.
Мы запустили его на папке, которую собрал код программы по настройкам этой статьи: два ролика по 20 копий, сетка на 10 аккаунтов. Имена копий — как у программы. Вывод (у каждого ролика первые три пары из десяти):
== D01_V_indoor_panrot_0001: копий 20
 1.00  D01_V_indoor_panrot_0001_13.mp4  D01_V_indoor_panrot_0001_16.mp4
 1.25  D01_V_indoor_panrot_0001_11.mp4  D01_V_indoor_panrot_0001_2.mp4
 1.25  D01_V_indoor_panrot_0001_12.mp4  D01_V_indoor_panrot_0001_14.mp4
Оставлено копий: 10. Самая близкая пара среди них: 3.00 бита
Перенесено в VUB_result_26092026_235740_лишние: 10

== D03_V_indoor_panrot_0001: копий 20
 1.38  D03_V_indoor_panrot_0001_14.mp4  D03_V_indoor_panrot_0001_19.mp4
 1.50  D03_V_indoor_panrot_0001_12.mp4  D03_V_indoor_panrot_0001_6.mp4
 1.62  D03_V_indoor_panrot_0001_15.mp4  D03_V_indoor_panrot_0001_16.mp4
Оставлено копий: 10. Самая близкая пара среди них: 2.50 бита
Перенесено в VUB_result_26092026_235740_лишние: 10
Из 40 копий в папке осталось 20, по десять на ролик. Остальные 20 скрипт перенёс в папку «_лишние». Самая близкая пара среди оставленных — 3 бита у одного ролика и 2,5 бита у другого, то есть оба прошли границу в два бита.
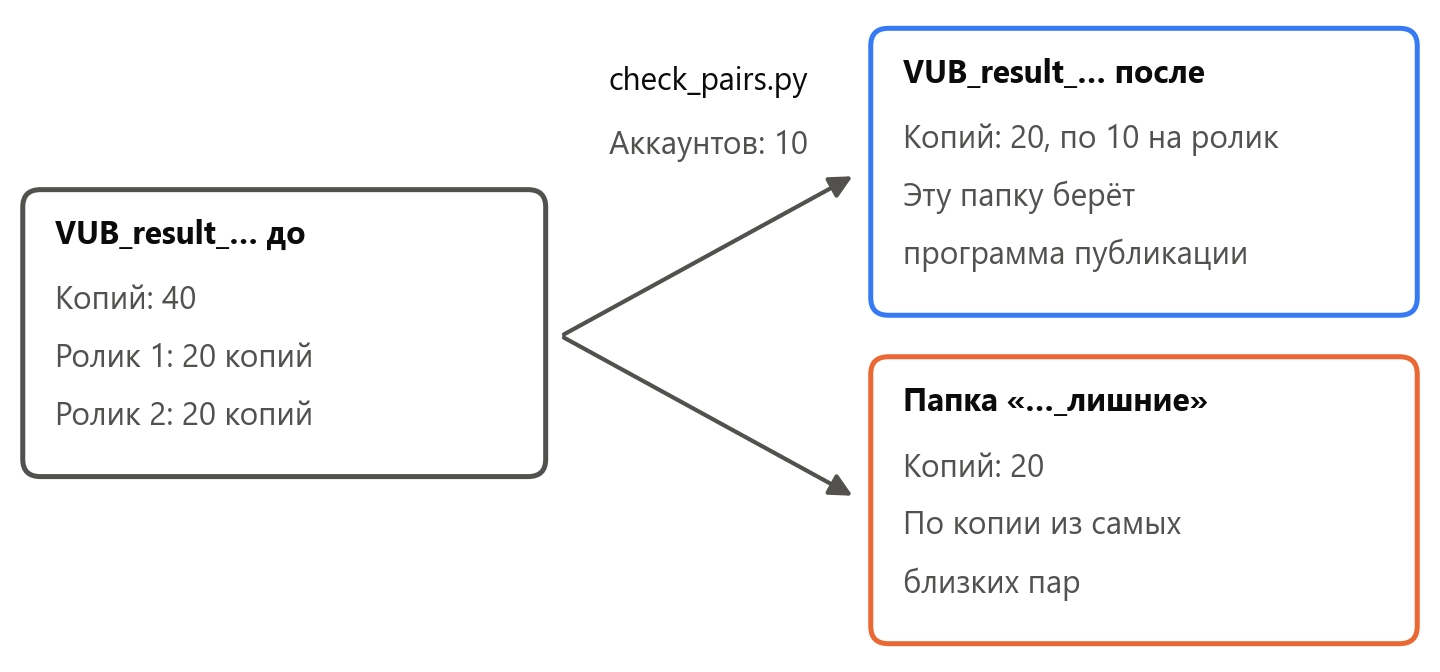
VUB_result_, по 10 на ролик, остальные 20 ушли в соседнюю папку «_лишние»Где это не работает
Кроме сходства роликов, площадка может связать аккаунты сетки и по другим признакам. По каким, Instagram не пишет. В нише говорят о доверии площадки, которое зависит от поведения аккаунта: «Это невидимая валюта, от которой зависит, проживет ваш аккаунт два часа или два месяца» 11.
Правило про неоригинальный контент касается аккаунта целиком. Правила говорят о существенной правке чужого материала, например шаблонов мемов 2. Рамку и смену скорости, которые есть и в нашем рецепте, они называют поверхностными правками 2. Это правило о чужом материале, а не о сверке одинаковых роликов. Наша сетка в 2025 году публиковала чужие ролики в уникальных копиях, и просмотры эти копии получали из рекомендаций. В апреле 2026 года Instagram объявил это правило заново 3. Как оно действует на такие копии теперь, мы не проверяли.
Мы считали свои хеши, а не хеши Instagram. Замер показывает, насколько копии похожи для открытых алгоритмов. Охваты на настоящих аккаунтах в замер не входили.
Замер шёл на наборах до 100 копий, то есть на сетке до 50 аккаунтов. У сотни аккаунтов пар ещё вчетверо больше. Хватит ли там запаса «вдвое», мы не проверяли. В нашей сетке новый ролик сначала публиковали на 30-50 аккаунтах, а для такой части сетки замер есть. На нашей сетке этот рецепт тоже не проверен: скрипт мы написали для замера в сентябре 2026 года, а сетка работала в 2025 году.
Частые вопросы
С чего начать
Шаги 1, 2 и 8 — из нашей сетки, остальные — рецепт этой статьи:
- Возьмите аккаунты возрастом от трёх месяцев. Описание с тегами сразу не ставьте.
- Пять дней публикуйте ролики для охвата и только потом ролики со ссылкой.
- Скачайте Video Unique Booster на главной странице.
- Включите правки по разделам программы, как в разделе «Настройки для сетки по разделам программы». Для зеркала выберите «Случайно», если в кадре нет надписей. В настройке «Как сохранять» выберите «В промежуточную папку результатов».
- Сделайте копий каждого ролика вдвое больше, чем аккаунтов, на которых его опубликуют.
- Проверьте папку
VUB_result_скриптом, указав то же число аккаунтов. Лишние копии он перенесёт в папку «_лишние». Если у ролика пара ближе двух бит, создайте его копии заново, поставив число побольше. - Направьте программу публикации на папку
VUB_result_: в ней остались только отобранные копии. - Новый ролик сначала опубликуйте на 30-50 аккаунтах. Если за день-два нет переходов, уберите его.
Читайте по теме:
- Как уникализировать видео для Инстаграм
- Уникализатор креативов: сотня копий одного ролика для запуска рекламы
- Уникализатор видео для TikTok
- Уникализатор видео для Ютуб
Источники
- Malik A. Instagram is updating its ranking systems to surface more content from smaller, original creators. TechCrunch, 2024. ↩︎
- Instagram. Original content guidelines. Instagram for Creators. ↩︎
- Instagram. Rewarding original creators on Instagram. Instagram for Creators, 2026. ↩︎
- Instagram algorithm 2024 changes. Digital Music News, 2024. ↩︎
- McKeown S., Buchanan W. J. Hamming Distributions of Popular Perceptual Hashing Techniques. DFRWS EU 2023. ↩︎
- Meta. The TMK+PDQF video-hashing algorithm and the PDQ image-hashing algorithm. ThreatExchange, GitHub. ↩︎
- Wang A. L. An Industrial-Strength Audio Search Algorithm. ISMIR 2003. ↩︎
- Kordopatis-Zilos G., Papadopoulos S., Patras I., Kompatsiaris Y. FIVR: Fine-Grained Incident Video Retrieval. IEEE Transactions on Multimedia, 2019. ↩︎
- Обсуждение «Массовая загрузка рилс в аккаунты». Zismo.biz, 2023. ↩︎
- Марков Д. Уникализация видео в TikTok и Instagram: 5 способов. YouTube. ↩︎
- Прогрев аккаунтов под разные площадки. Pirate CPA, 2026. ↩︎
- Python: страница загрузки. Официальный сайт проекта. ↩︎
- FFmpeg: страница загрузки. Официальный сайт проекта. ↩︎
- ImageHash: библиотека перцептивных хешей. GitHub. ↩︎
- Instagram. Add and switch between multiple accounts. Instagram Help Center. ↩︎
- Shullani D., Fontani M., Iuliani M., Al Shaya O., Piva A. VISION: a video and image dataset for source identification. EURASIP Journal on Information Security, 2017. ↩︎
- Pillow: установка. Документация проекта. ↩︎
- FFmpeg: сборки для Windows. gyan.dev. ↩︎
- Six J., Leman M. Panako: A Scalable Acoustic Fingerprinting System Handling Time-Scale and Pitch Modification. ISMIR, 2014. ↩︎
- InstAccountsManager. Perfect.Studio. ↩︎
- Запускаем сетку аккаунтов в Instagram. Teletype. ↩︎
- KalininLive. Как на автомате заливать Reels в 100+ аккаунтов. YouTube. ↩︎